※本記事にはプロモーション(広告)が含まれています。
たとえば客先から「この2工程、不良率に差があるんですか?データで示してください」と聞かれたとします。でも、それぞれのサンプルが5個ずつしか取れていない。Excelでカイ二乗検定を試したら「期待度数が小さすぎます」みたいな話になって、これでいいのか自信が持てない…。
少ないデータでの比較は、品質の現場でよくある場面です。どの検定を使えばよいかは、手順さえ押さえれば迷いません。
- サンプルが数個しか取れず、カイ二乗検定でいいのか不安になった
- 「期待度数が5未満」という言葉は聞くが、何がダメなのか説明できない
- 両側と片側、どっちで検定すればいいのか毎回迷う
- フィッシャーの正確確率検定とは何か(中学生でもわかる説明)
- 5個ずつのデータでの計算手順(途中式を省略しません)
- 両側・片側の選び方と、実務でつまずくポイント
フィッシャーの正確確率検定は、2×2の表で、期待度数が5未満のマスがありカイ二乗検定が使えないときに、「差がないとしたら今の偏りが偶然に起きる確率」を組み合わせで正確に計算する検定です。5個中4個と5個中1個の成功の例では、両側P値は約0.21で、5%では「差があるとは言えない」と判定します。
フィッシャーの正確確率検定とは?まず結論から
先に結論を言います。フィッシャーの正確確率検定とは、サンプルが少なすぎてカイ二乗検定が使えないときに、近似を使わず「正確な確率」を直接計算して差があるか判定する検定です。
主に「合格/不合格」「良品/不良品」のような2×2の表(2行2列)で、2つのグループの比率に差があるかを調べるときに使います。
カイ二乗検定は「近似」で計算するため、サンプルが少ないと誤差が大きくなります。フィッシャー検定は近似せず、起こりうる組み合わせの確率を1つずつ足し上げるので、サンプルが少なくても正確です。だから「最終兵器」と呼ばれます。
なぜカイ二乗検定が使えないのか?
カイ二乗検定には「期待度数が5以上であること」という使用条件があります。期待度数とは、ざっくり言えば「もし差がなかったら、各マスに入るはずの理論上の個数」です。
寸法検査で例えると分かりやすいです。1個や2個の測定値で「この工程は規格を満たしている」と言い切れないのと同じで、各マスの個数が少なすぎると、カイ二乗検定の計算結果がブレて信用できなくなります。
判断基準はシンプルです。期待度数が5未満のマスが1つでもあれば → フィッシャー検定。すべて5以上なら → カイ二乗検定。迷ったら期待度数を計算して、この基準で機械的に決めればOKです。

イメージは「箱からボールを取り出す確率」
フィッシャー検定がやっていることは、実は単純です。「もし2つのグループにまったく差がないとしたら、今手元にあるデータみたいな偏った結果が、偶然どれくらいの確率で起きるか」を計算しているだけです。
これは、1つの箱にボールを全部入れて、目をつぶってランダムに取り分けたとき、たまたま今のような偏りが出る確率を計算するのと同じです。その確率がものすごく低ければ(5%未満なら)、「偶然じゃない=差がある」と判断します。
「正確確率」という名前が難しそうに聞こえますが、やっていることは中学校の確率の問題と同じです。組み合わせ(C=コンビネーション)を使って、起こりうるパターンの確率を数えているだけ。身構えなくて大丈夫です。
フィッシャー検定の公式
2×2の表を下のように置きます。a・b・c・dは各マスの個数です。
| 成功 | 失敗 | 合計 | |
|---|---|---|---|
| グループ1 | a | b | a+b |
| グループ2 | c | d | c+d |
| 合計 | a+c | b+d | n |
P = ( (a+b)! × (c+d)! × (a+c)! × (b+d)! ) ÷ ( n! × a! × b! × c! × d! )
「!」は階乗です。たとえば 5! = 5×4×3×2×1 = 120 のこと。記号が並ぶと難しく見えますが、表の周辺の合計(行と列の合計)の階乗をかけて、全体と各マスの階乗で割っているだけです。
計算例:5個ずつのデータで差があるか判定する
具体的な数字でやってみましょう。次のようなデータが取れたとします。横にExcelを開いて、一緒に計算してみてください。
| 成功 | 失敗 | 合計 | |
|---|---|---|---|
| グループ1 | 4 (a) | 1 (b) | 5 |
| グループ2 | 1 (c) | 4 (d) | 5 |
| 合計 | 5 | 5 | 10 |
グループ1は5個中4個成功、グループ2は5個中1個成功。見た目には大きな差がありそうですが、サンプルが少ないので「偶然この差が出ただけかも」と疑ってかかる必要があります。それを確率で確かめるのがこの検定です。

計算ステップ:途中式を省略せずに追う
まず「今のデータ(a=4)が起きる確率」を公式に当てはめて計算します。これからやるのは、公式に数字を入れるだけです。
STEP1:分母にあたる全体の組み合わせを出す
10個から成功5個を選ぶ組み合わせの総数を出します。これが確率の「分母」になります。
C(10,5) = 10! ÷ (5! × 5!) = 3,628,800 ÷ (120 × 120) = 3,628,800 ÷ 14,400 = 252
STEP2:今のデータ(成功4個)の確率を出す
グループ1で成功4個、グループ2で成功1個になる組み合わせの数を、分母252で割ります。
C(5,4) × C(5,1) ÷ 252
= 5 × 5 ÷ 252
= 25 ÷ 252
≈ 0.0992(約9.9%)
STEP3:もっと極端なデータ(成功5個)の確率を出す
検定では「今のデータ」だけでなく「今より極端なデータ」の確率も足します。なぜなら「これくらい以上に偏る確率」を知りたいからです。今より極端なのは、グループ1が全部成功(5個)のケースです。
C(5,5) × C(5,0) ÷ 252
= 1 × 1 ÷ 252
= 1 ÷ 252
≈ 0.0040(約0.4%)
P値を出して判定する(片側・両側)
STEP2とSTEP3を足すと、「片側のP値」が出ます。これは「グループ1がこれくらい以上に成功する確率」です。
0.0992 + 0.0040 ≈ 0.103(約10.3%)
そして「どちらに偏っても構わない」という普通の検定では、両側で見ます。反対方向(グループ2の方が成功が多い)の同じくらい偏ったケースも足すので、両側P値はおよそ次のようになります。
約0.21(約21%)
片側P値(0.103)も両側P値(0.21)も、有意水準5%(0.05)を上回っています。つまり「4対1」という見た目の差があっても、統計的には『差があるとは言えない』という結論になります。サンプルが5個ずつでは、これくらいの差は偶然でも普通に起こるのです。

Excelで計算する|HYPGEOM.DISTと両側P値の決め方
フィッシャー検定の確率は、Excelの超幾何分布の関数 HYPGEOM.DISTで求められます。引数は「グループ1の成功数, グループ1の個数, 成功の合計, 全体の個数, FALSE(その値ちょうどの確率)」です。
| グループ1の成功数 a | Excelの式 | 確率 |
|---|---|---|
| 0 | =HYPGEOM.DIST(0,5,5,10,FALSE) | 1÷252 ≒ 0.0040 |
| 1 | =HYPGEOM.DIST(1,5,5,10,FALSE) | 25÷252 ≒ 0.0992 |
| 2 | =HYPGEOM.DIST(2,5,5,10,FALSE) | 100÷252 ≒ 0.397 |
| 3 | =HYPGEOM.DIST(3,5,5,10,FALSE) | 100÷252 ≒ 0.397 |
| 4(今回) | =HYPGEOM.DIST(4,5,5,10,FALSE) | 25÷252 ≒ 0.0992 |
| 5 | =HYPGEOM.DIST(5,5,5,10,FALSE) | 1÷252 ≒ 0.0040 |
両側P値は、「今回のデータ(a=4)の確率 0.0992 以下になる場合の確率をすべて足したもの」です。a=0・1・4・5 が当てはまるので、(1+25+25+1)÷252=52÷252≒0.206。片側P値(a=4・5)は 26÷252≒0.103 です。合計が252通りになることも、表の確率を全部足すと1になることで確かめられます。
ソフトによって両側P値の決め方(片側の2倍か、確率の小さい順に足すか)が違うことがある。報告するときは、どちらの方法かを書いておく。
両側?片側?どっちを使えばいいのか
ここが実務で一番つまずくポイントです。結論を言うと、「ただ差があるか知りたい」なら両側、「グループ1の方が良いと言いたい」など方向が決まっているなら片側です。
客先監査のように中立に差を見たい場面では、原則として両側を使うのが安全です。理由は、片側は「最初から片方に決め打ち」しているため、有意になりやすく、結論が甘くなりがちだからです。
片側だと有意になるのに両側だと有意にならない、というのはよくあります。ここで「有意にしたいから片側を選ぶ」のは絶対NG。「なぜ片側なんですか?」と聞かれて答えられなくなります。検定の前に「方向を決めてよい理由があるか」を先に決めておくのが鉄則です。
実務での落とし穴:「有意差なし」の意味
今回のように「有意差なし」となったとき、一番やってはいけない解釈があります。それは「有意差なし=差がない」と言い切ってしまうことです。
正しくは「このサンプル数では、差があるとは言えなかった」です。本当は差があるのに、データが少なすぎて検出できていないだけかもしれません。寸法検査で2個しか測らずに「ばらつきなし」と言えないのと同じ理屈です。
少数データで「差がない」と主張したいなら、検定のP値だけでなく、必要なサンプル数(検出力)も併せて考える必要があります。「何個取れば差を検出できたのか」を示せると、客先への説明が一気に説得力を持ちます。

よくある質問(FAQ)
Q. サンプルが多くてもフィッシャー検定は使える?
使えます。フィッシャー検定はサンプルが多くても正確です。ただし階乗の計算がとても大きくなり、手計算は現実的でなくなります。サンプルが多い(期待度数が全マス5以上)なら、計算が軽いカイ二乗検定で十分です。
Q. ExcelやRではどう計算する?
Rなら fisher.test() という関数に2×2の表を渡すだけで、P値が一発で出ます。Excelには標準関数がないため、今回のように COMBIN関数(組み合わせ)を使って手で組むか、統計アドインを入れる必要があります。実務ではRが圧倒的にラクです。
Q. 2×2より大きい表でも使える?
使えます(拡張版のフィッシャー検定があります)。ただし計算が一気に重くなるので、ソフトに任せるのが基本です。まずは2×2でこの記事の考え方をマスターすれば十分です。
まとめ:少数データの差はフィッシャー検定で
- 期待度数が5未満のマスがあれば、カイ二乗ではなくフィッシャー検定を使う
- やっていることは「箱からボールを取り出す確率」の計算と同じ
- P値は「今のデータ+より極端なデータ」の確率を足して求める
- 中立に差を見るなら両側検定が原則。片側は方向の理由があるときだけ
- 「有意差なし」は「差がない」ではなく「差があるとは言えない」
これで、「サンプルが少ないので、フィッシャーの正確確率検定で確認しました。両側P値は0.21で、統計的には差があるとは言えません」と、根拠を持って説明できるようになりましたね。
「フィッシャーの正確確率検定」の土台になる統計学を、本でじっくり学び直したいときに向いています。統計学を独学で学べるように書かれた入門書です(ダイヤモンド社、小島寛之 著)。
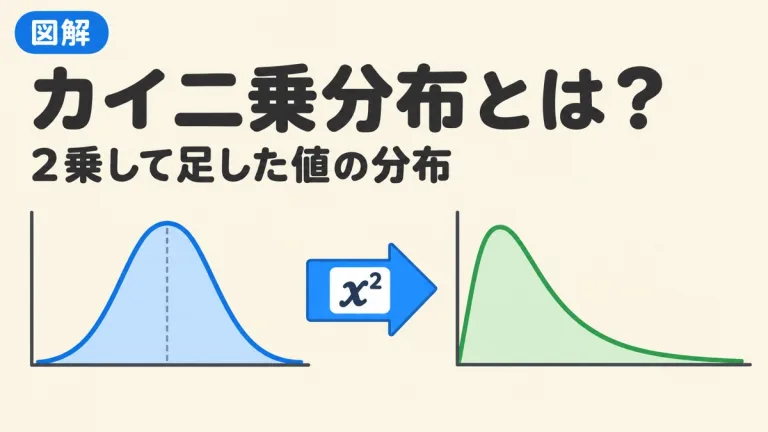
データが多いときに使うカイ二乗分布と、独立性の検定・適合度の検定の計算例を確かめられます。

QC検定2級の受験を考えているなら、過去問で出題のされ方を確かめておきましょう。QC検定2級の過去問題を、解説つきで学べる問題集です(日本規格協会、2026年版)。

「フィッシャーの正確確率検定」の土台になる統計学を、検定まで含めて1冊で学びたいときに向いています。検定から多変量解析・実験計画法・ベイズ統計学までを扱う、統計学の入門書です(オーム社、栗原伸一 著、第2版)。

メーカーで回路設計と生産技術(品質改善)に携わってきた経験をもとに執筆しています。むずかしい専門用語をできるだけ使わず、はじめて学ぶ人がつまずかないように、図とたとえで説明することを大切にしています。
次に読むべき記事
この記事の内容がわかったら、計数値の検定の次のテーマに進みましょう。続けて読むと、現場でそのまま使える知識になります。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめて学ぶ人向けにやさしく書いています。