※本記事にはプロモーション(広告)が含まれています。
結論|まず30秒でわかる答え
t分布は、母分散がわからないときに標本の標準偏差 s を使って計算した t=(x̄−μ)÷(s/√n) が従う分布です。形は正規分布に似た釣鐘型ですが裾が広く、データが少ない(自由度が小さい)ほど裾が広がって臨界値が大きくなります。自由度9なら両側5%の臨界値は2.262で、自由度が大きくなると正規分布の1.96に近づきます。
自由度と境界値 t分布の自由度は、1標本なら n−1、2標本(等分散)なら n1+n2−2 です。自由度が小さいほど裾が厚く、両側5%の境界は自由度9で 2.262、自由度が大きくなると 1.96 に近づきます。例題はt検定(1標本) とウェルチの t検定 で解いています。
この記事でわかること
t分布 がどんな形をしているかイメージでわかるなぜデータが少ないと判定基準が厳しくなる のか理解できる
自由度 t分布が正規分布に近づいていく 仕組みがわかる
この記事を読む前に
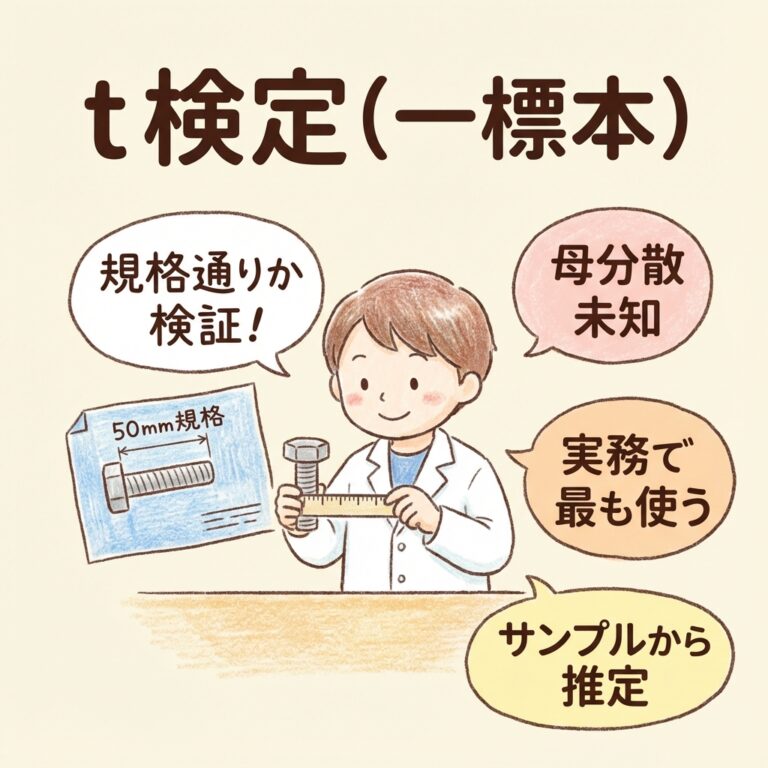
この記事はt検定(一標本) の続きです。
→ t分布とは?|基礎から完全図解で学ぶ
前回、t検定 の計算方法を学びましたね。
その中で、こんな疑問を持ちませんでしたか?
「なんでZ検定は1.96なのに、t検定は2.262とか違う値なの?」
この疑問の答えは、t分布の「形」 を見れば一発でわかります。
今回は、t分布と自由度 の関係を、イメージで徹底的に理解 していきましょう。
t分布のイメージ|「自信がない分、広く構える」
まず、t分布がどんな形をしているか、イメージで掴みましょう。
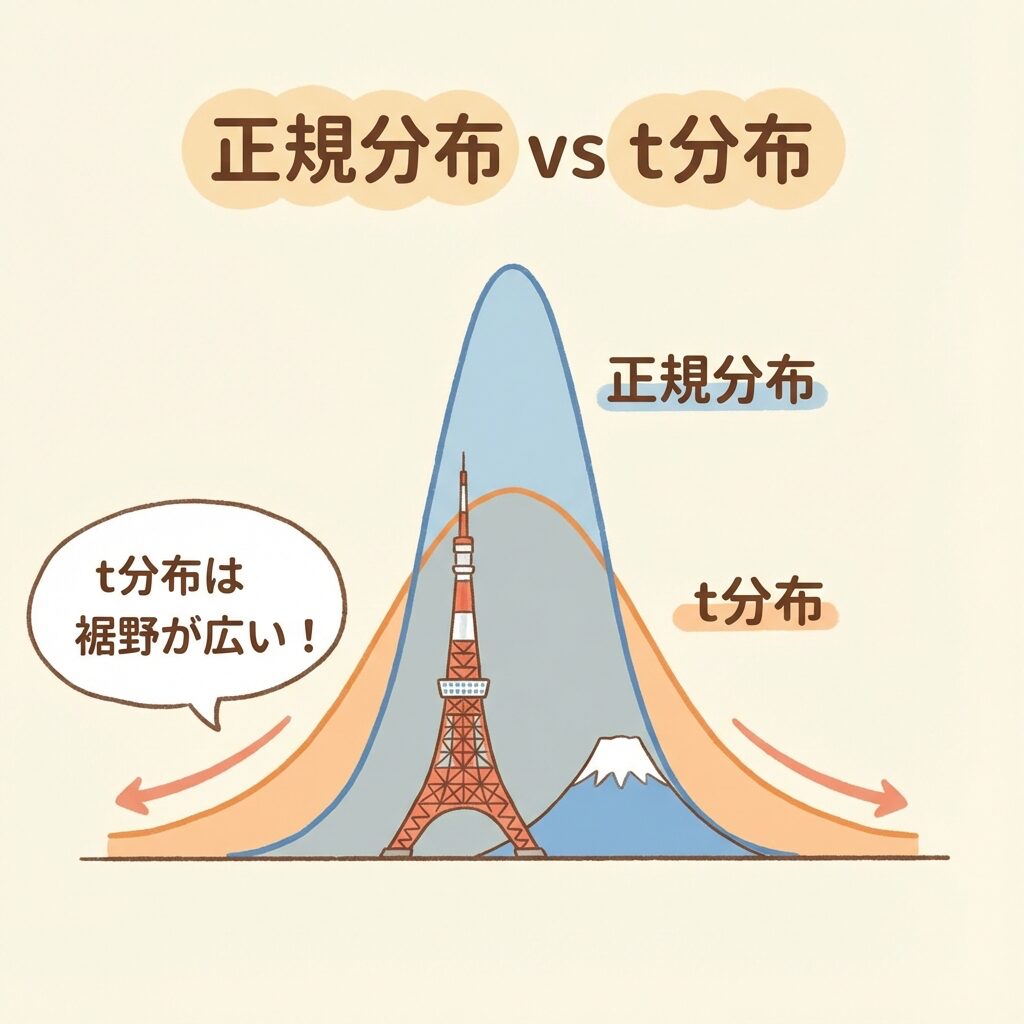
正規分布とt分布を並べてみよう
正規分布 とt分布、どちらも「釣鐘型(ベルカーブ)」の形をしています。
でも、よく見ると違いがあります 。
t分布は正規分布より裾野が広い
正規分布 vs t分布の形
t分布は正規分布より「ずんぐりむっくり」した形
t分布の特徴は、「裾野が広い」 ことです。
これを別の言い方をすると、「極端な値が出やすい」 ということになります。
たとえ話で理解しよう|「慎重なアーチャー」
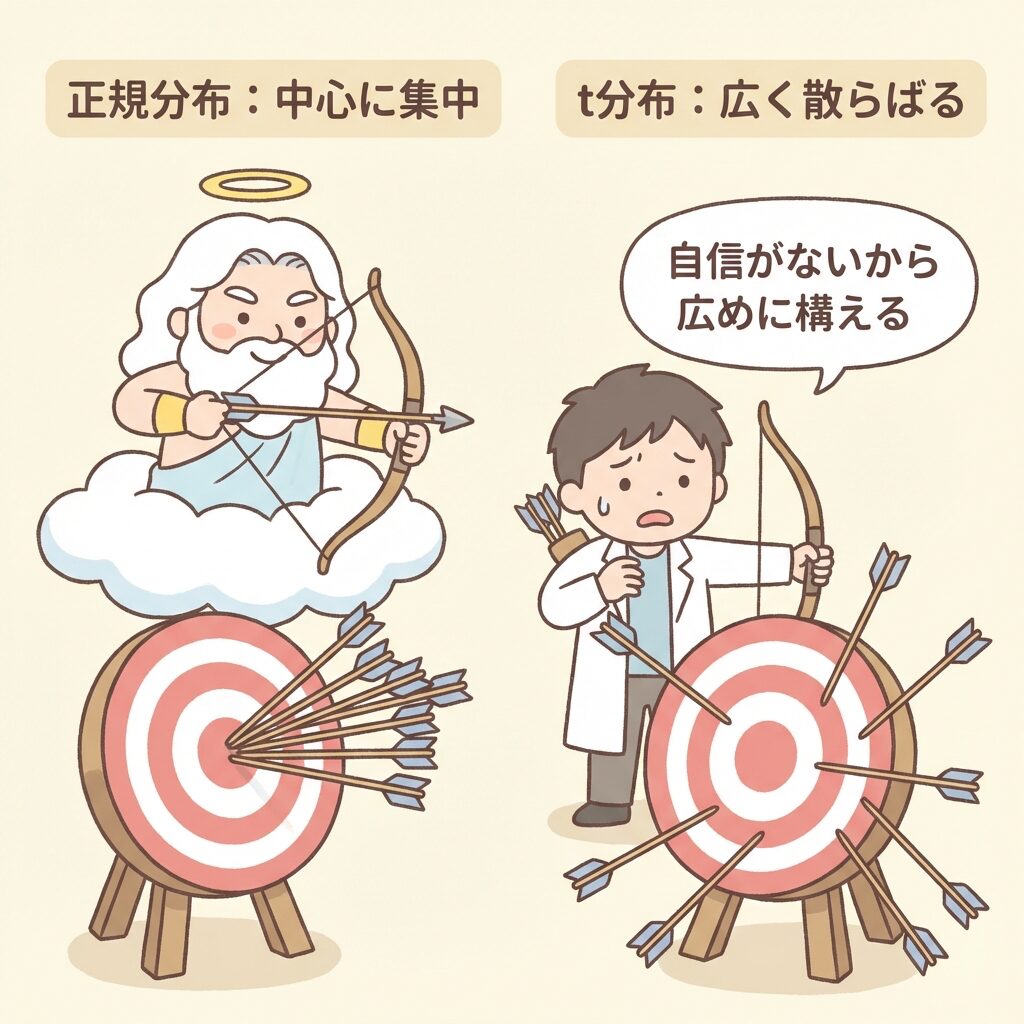
t分布と正規分布の違いを、弓矢の的当て でたとえてみましょう。
「的当てゲーム」でたとえると…
神様(正規分布・Z検定)
「的の位置を完璧に知っている 」中心付近に集中 する
人間(t分布・t検定)
「的の位置をだいたいしか知らない 」中心からズレやすい (裾野が広い)
t分布の「裾野が広い」とは、「不確実さを反映している」 ということなんです。
自由度とは?|「自信の度合い」を表す数字
t検定では、自由度
一標本t検定の場合、自由度 = n − 1 (データ数 − 1)です。
この「自由度」は、t分布の「形」を決める パラメータです。
自由度が変わると、t分布の形はどう変わる?
ここが今日の最重要ポイント です。
t分布はσを知らないぶん広めに構える
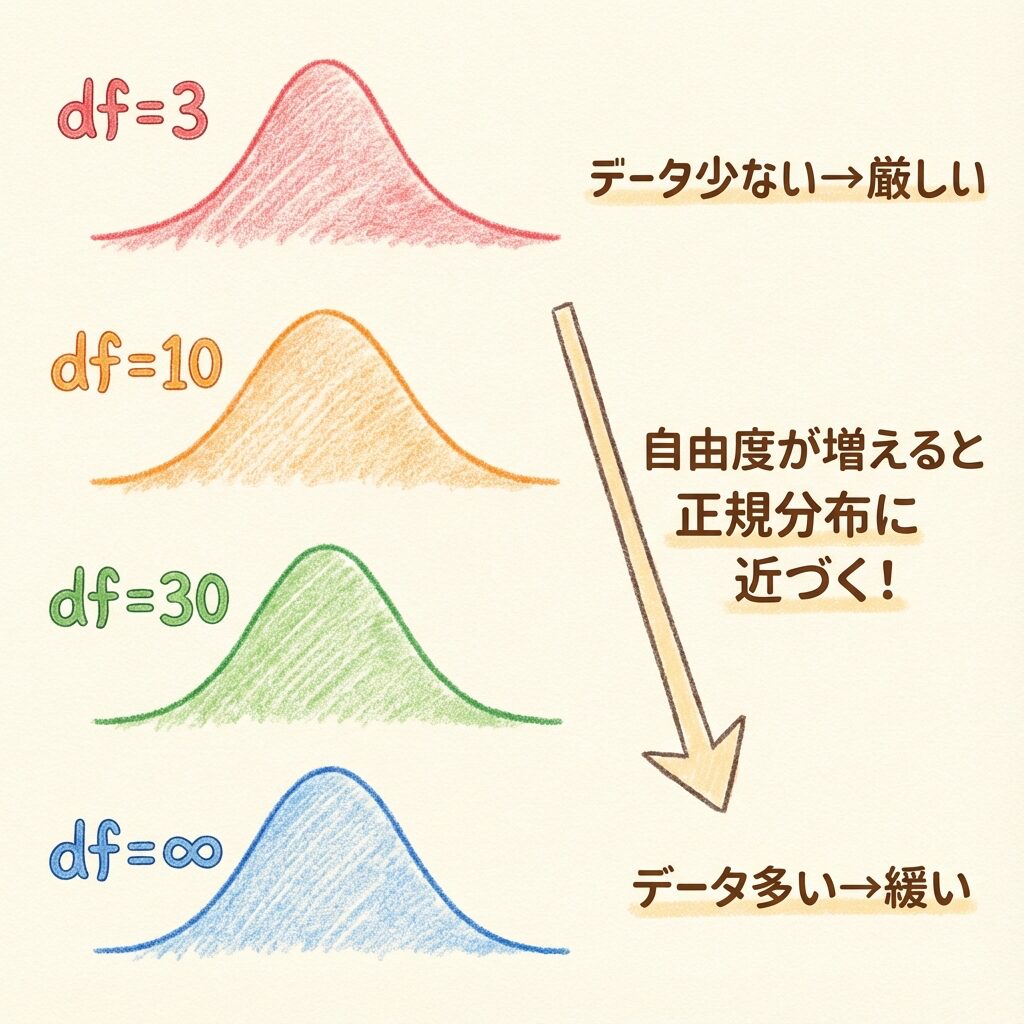
自由度が変わると、t分布の形はこう変わる!
df=3
自由度が小さい(データが少ない)
裾野がとても広い → 極端な値が出やすい → 判定基準がかなり厳しい
df=10
自由度が中くらい
裾野がやや広い → まだ正規分布より不確実 → 判定基準がやや厳しい
df=30
自由度が大きい(データが多い)
裾野が狭くなる → 正規分布に近づく → 判定基準が緩くなる
df=∞
自由度が無限大
正規分布と一致! → 判定基準は1.96 (Z検定と同じ)
超重要ポイント
自由度が大きくなる → t分布は正規分布に近づく
たとえ話で理解しよう|「経験を積んだ職人」
「寿司職人」でたとえると…
新人職人(自由度が小さい=データが少ない)
「まだ3回しか握ってない…」自信がない 厳しい目 で見る
ベテラン職人(自由度が大きい=データが多い)
「10000回握ってきた」自信がある 信頼 する
経験(データ)が少ないうちは、「たまたまうまくいった」可能性 を疑われる。
臨界値の変化を数字で確認しよう
「裾野が広い」「判定基準が厳しい」という話を、実際の数字 で確認しましょう。
仮説検定とは?帰無仮説・P値・有意水準と手順5ステップを例題で図解(P値と有意水準αの違い) のときの臨界値を見てください。
自由度が増えるとt分布は正規分布に近づく t分布の式と性質|t表・Excelでの読み方 母集団が正規分布のとき、標本平均を標準化した値は、母標準偏差σを使えば正規分布に、σの代わりに標本の標準偏差 s を使うと自由度 n−1 のt分布 に従います。
性質 内容 形 0を中心に左右対称の釣鐘型。正規分布より山が低く、裾が広い 平均 0(自由度2以上のとき) 分散 φ÷(φ−2)(自由度φが3以上のとき)。φ=10なら1.25で、正規分布の1より大きい 自由度が大きくなると 分散が1に近づき、標準正規分布に近づく
t表は「両側」か「片側」かを確かめて読む t表には、両側確率で並べた表と片側確率で並べた表があります。両側5%の値(自由度9なら2.262)は、片側2.5%の値と同じです。表の見出しが「P(両側確率)」か「α(片側)」かを最初に確かめると、読み違いを防げます。
Excelなら、=T.INV.2T(0.05, 9) で両側5%の臨界値2.262が、=T.INV(0.95, 9) で片側5%の臨界値1.833が求まります。
つまり t分布は「σの代わりに s を使った分の不確かさ」を裾の広さで表した分布。自由度が増えるほど s が安定し、正規分布に近づく。
自由度
データ数
臨界値
判定の厳しさ
3
4
3.182 かなり厳しい
5
6
2.571 厳しい
9
10
2.262 やや厳しい
19
20
2.093 普通
29
30
2.045 ほぼ正規分布
∞
∞
1.960 正規分布と一致
表から読み取れること
自由度3(データ4個)では、臨界値が3.182 (かなり厳しい!)
自由度が増えると、臨界値はだんだん小さく なる
自由度∞では、臨界値が1.960 (Z検定と同じ!)
一般的に、自由度30以上 なら正規分布とほぼ同じとみなせる
図でイメージしよう|「ゴールラインの位置」
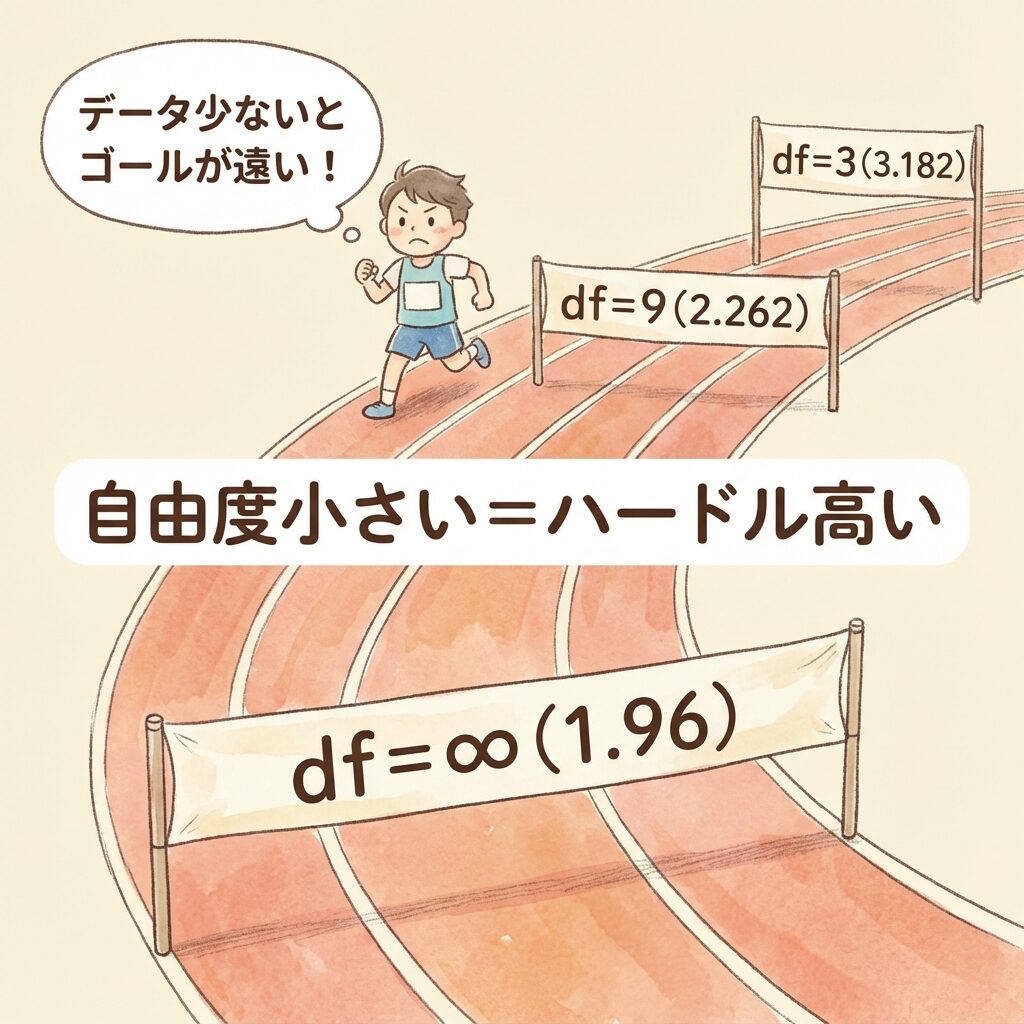
臨界値の違いを、「ゴールラインの位置」 でたとえてみましょう。
「有意差を出す」=「ゴールラインを超える」
0 ─────────────────────── │ 3.182 (df=3) 0 ───────────────────── │ 2.571 (df=5) 0 ─────────────────── │ 2.262 (df=9) 0 ───────────────── │ 1.960 (df=∞)
データが少ないと、ゴールラインが遠くにある (超えるのが大変)ゴールラインが近くにある (超えやすい)
なぜ「厳しく」する必要があるのか?
「データが少ないから厳しくする」というのは、感覚的には理解できますよね。
でも、なぜ統計学的にそうなるのか 、もう少し深掘りしてみましょう。
理由①:標本標準偏差の「ブレ」が大きい
t検定では、母分散の代わりに標本標準偏差(s) を使います。
でも、この「s」はサンプルから計算した推定値 です。
データが少ない場合
サンプルが少ない不安定
データが多い場合
○
サンプルが多い安定
データが少ないと、標本標準偏差sが真の値からズレやすい んです。
そのズレを考慮して、判定基準を厳しくしておく 必要があるのです。
詳しくは自由度とは?(数式なしで納得するn−1) で解説しています。
臨界値:df=3で3.182、df=9で2.262、df=∞で1.96
現場ではこう使う/ここでつまずく
品質保証の現場では、試作品の評価や破壊試験のように「サンプルが3個や5個しか取れない」場面が日常的にあります。本記事のとおり自由度が小さいほど臨界値が大きくなる(判定が厳しくなる)ので、少サンプルの試験では「差があるはずなのに有意にならない」ことが頻発します。これは検出力が低いせいで、t検定が正しく機能している証拠でもあります。ここで「有意差なし=差がない」と結論づけてしまうのが一番多いミスです。正しくは「このサンプル数では差を検出できなかった」であって、差がないことの証明にはなりません。
理由②:「たまたま」のリスクを抑える
データが少ないと、「たまたま」極端な結果が出やすい んです。
「コイン投げ」でたとえると…
コインを4回投げた場合
「4回中4回とも表が出た!」 → 表の確率100%?いやいや、たまたまでしょ… と疑う余地がある
コインを100回投げた場合
「100回中52回表が出た」 → 表の確率約50%これなら信頼できそう と思える
データが少ない状態で「有意差あり!」と判定すると、第1種の過誤 (あわてんぼうのミス)
そのリスクを抑えるために、判定基準を厳しくする のです。
実務での目安|「自由度30」がひとつの境界線
統計学の世界では、こんな目安があります。
実務での目安
自由度 ≤ 30 (データ31個以下):t分布を使う自由度 > 30 (データ32個以上):正規分布で近似してもOK
※ 厳密には、常にt分布を使う方が正確です。
t分布誕生の物語 〜ビール会社の品質管理〜 ここで、t分布がどのように生まれたのか、その歴史を見てみましょう。
1908年、アイルランドのダブリン ギネスビールで有名なギネス社 で働く統計学者、ウィリアム・シーリー・ゴセット さんには、大きな悩みがありました。
ゴセットさんの悩み
「ビールの品質をチェックしたいけど、毎日何百本も検査するわけにはいかない…。せいぜい10〜20本 が限界だ」
当時、品質管理といえば正規分布 を使うのが常識でした。でも、正規分布は「データがたくさんある」ことが前提。少ないデータで使うと、信頼性に問題が…。
画期的な発見 そこでゴセットさんは考えました。
「少ないデータでも使える、新しい分布 を作れないかな?」
研究の結果、ついに「データ数が少ない時の不確かさを考慮した分布」 を発見!これが現在のt分布 です。
なぜ「Student」なのか? でも、ギネス社は社員の研究成果を外部発表することを禁止 していました。
そこでゴセットさんは、「Student(学生)」 という偽名で論文を発表したのです!
だから今でも…
t分布 → 「Student's t-distribution 」
t検定 → 「Student's t-test 」と呼ばれる
普段飲んでいるビールの品質管理から生まれた分布が、今では世界中で使われているなんて、素敵な話ですよね!
t分布が活躍する場面 t分布は、実は私たちの身近なところで大活躍しています。
場面①:製品の品質管理 「新製品の試作品が10個しかない。この品質は基準を満たしている?」
場面②:医薬品の効果測定 「治験参加者が20人だけ。この薬は効果がある?」
場面③:マーケティング効果測定 「A/Bテストの各グループが25人ずつ。どっちの広告が効果的?」
場面④:教育効果の測定 「新しい教材を試したクラスが18人。成績は上がった?」
まとめ|t分布は「不確実さの反映」
この記事のまとめ
t分布は正規分布より裾野が広い (極端な値が出やすい形)
自由度が小さい ほど裾野が広く、判定基準が厳しくなる 自由度が大きくなる と、t分布は正規分布に近づく自由度∞で正規分布と一致 (臨界値1.96)
これは「データが少ない=不確実」を数学的に反映している
覚え方のコツ
自由度が小さい = 自信がない = 厳しく判定 新人は厳しく評価される、ベテランは信頼されるのと同じ!
t分布と自由度の関係を理解したら、次は「2つのグループを比較するt検定」 を学びましょう。
「A組とB組の平均に差はあるか?」のような、2標本の比較 ができるようになります。
ここまで読んでくださった方へ
「なぜ自由度で判定基準が変わるのか?」データが少ない=不確実=厳しく判定
よくある質問
Q. サンプルが何個以上あればZ検定(1.96)を使っていい?
A. 目安は自由度30(n=31程度)以上です。実務では母分散が未知ならnが大きくてもt検定で問題ありません。
Q. 自由度はいつもn−1ですか?
A. 一標本t検定はn−1ですが、2標本(等分散)はn₁+n₂−2など、検定の種類で変わります。
この記事の理解を深める本と道具
おすすめの本
「t分布と自由度」の土台になる統計学を、本でじっくり学び直したいときに向いています。統計学を独学で学べるように書かれた入門書です(ダイヤモンド社、小島寛之 著)。
¥2,420 (2025/11/23 09:57時点 | Amazon調べ)
ポチップ
おすすめの本
QC検定2級の受験を考えているなら、過去問で出題のされ方を確かめておきましょう。QC検定2級の過去問題を、解説つきで学べる問題集です(日本規格協会、2026年版)。
楽天ブックス
¥4,400 (2026/10/24 12:31時点 | Amazon調べ)
ポチップ
おすすめの本
「t分布と自由度」の土台になる統計学を、検定まで含めて1冊で学びたいときに向いています。検定から多変量解析・実験計画法・ベイズ統計学までを扱う、統計学の入門書です(オーム社、栗原伸一 著、第2版)。
¥2,860 (2026/10/06 07:36時点 | Amazon調べ)
ポチップ
S
シラス
電験三種・QC検定1級 / メーカーでパワエレ設計・品質保証 実務10年
製造業の品質保証の現場で、試作評価や破壊試験など「サンプルが数個しか取れない」状況でt検定を実際に使ってきました。少サンプルだと有意差が出にくいこと、それを「差がない」と取り違えないこと、測る前にサンプル数を決めることといった、現場でつまずきやすい点を自分の経験を踏まえて解説しています。
テーマ別に、もっと深く学ぶ 気になるところから読んでも大丈夫です。どの記事も、はじめて学ぶ人向けにやさしく書いています。
つまずきやすい「違い」を一気に解決
計算力アップ・資格対策