※本記事にはプロモーション(広告)が含まれています。
- 「相関」と「回帰」、似ているけど何が違うのかハッキリ言えない
- 散布図や相関係数(r)の意味が、なんとなくでしか分からない
- y=ax+b は知っているが、なぜそれが「予測」に使えるのか腑に落ちない
- 「信頼区間」と「予測区間」の違いがわからず混乱している
- 相関と回帰の違いが一言でわかる
- 散布図の見方と相関係数(r)の意味
- 単回帰の式 y=ax+b の意味と「線形」とは何か
- 単回帰の例題(気温とアイスの売上)で、式の作り方と決定係数 R² の見方
- 回帰分析を正しく使うための4つの前提条件
- 信頼区間と予測区間の違い(どちらが広いか)
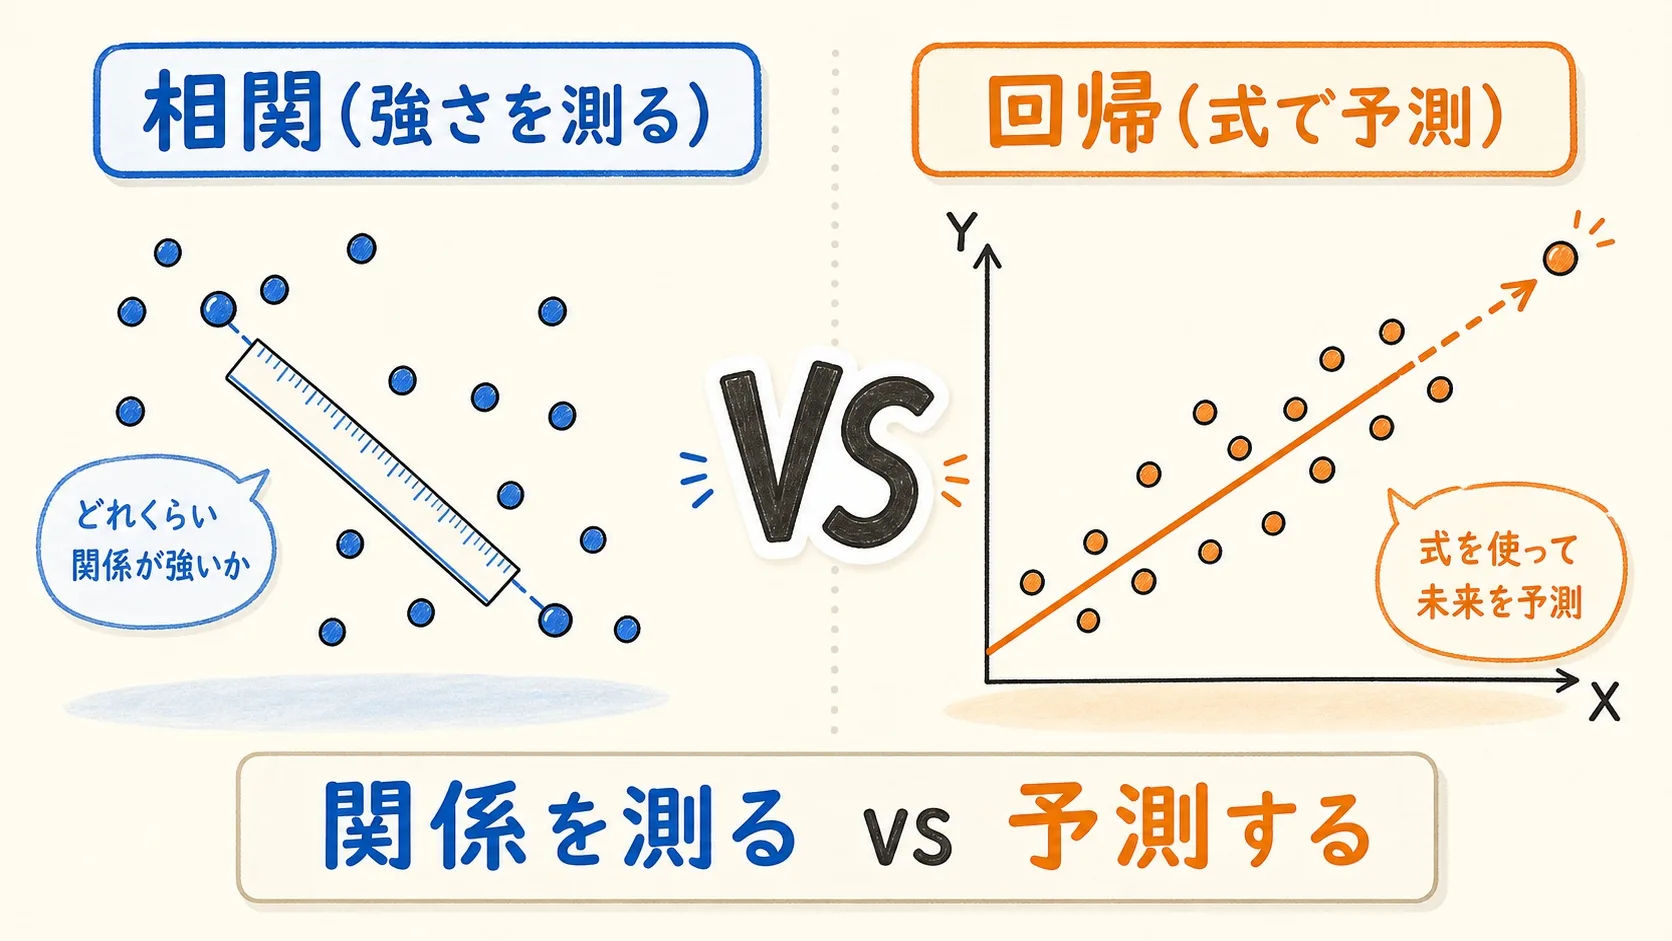
回帰分析とは、原因となるデータ(x)から結果のデータ(y)を、式 y=ax+b で予測する方法です。似た言葉の「相関」との違いは一言でこうです。
・相関=2つのデータの関係の「強さ」を数値(相関係数 r)で測るだけ。例:「身長と体重は関係が深いか?」
・回帰=その関係を「式(y=ax+b)」にして、未知の値を予測する。例:「身長が1cm増えたら体重は何kg増える?」
相関で「関係がありそう」と確かめ、回帰で「具体的に予測する」。この流れで理解すればスッキリします。
そもそも回帰分析とは?「未来を予測する」道具
回帰分析とは、「あるデータ(原因)から、別のデータ(結果)を予測する」道具です。むずかしく考えなくて大丈夫です。あなたも日常で無意識にやっています。
・「気温が上がると、アイスがよく売れる」→ 明日30℃なら、アイスはこれくらい売れそう
・「勉強時間が長いほど、点数が上がる」→ 10時間勉強すれば、何点くらい取れそう
この「○○なら、たぶん□□になる」を、データから数式で導くのが回帰分析です。
「平均」だけでは足りない、3つの理由
- 変化量がわかる。「気温が1℃上がると、売上は何個増える?」は、売上の平均を見てもわかりません。回帰直線の傾きがこの問いに答えます。
- 条件が変わったときの予測ができる。来週の気温が今週と違うなら、過去の平均売上は役に立ちません。式に新しい気温を入れれば、その条件での予測が出ます。
- 数字で説得できる。「たぶん増える」ではなく「1℃で約10個増える」と示せます。式がどれだけ当てはまっているかは、決定係数 R²(後半の例題で計算します)で示せます。
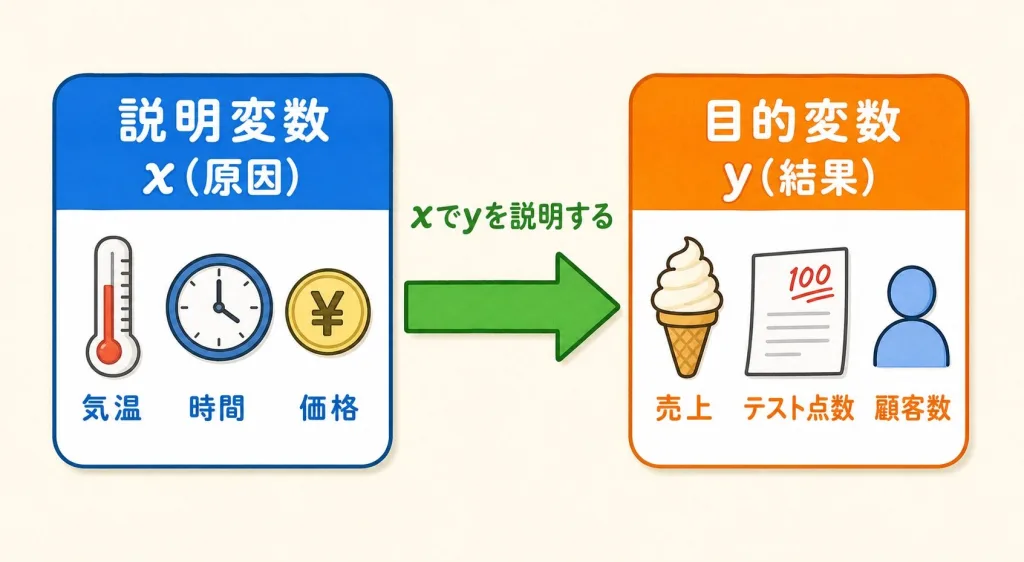
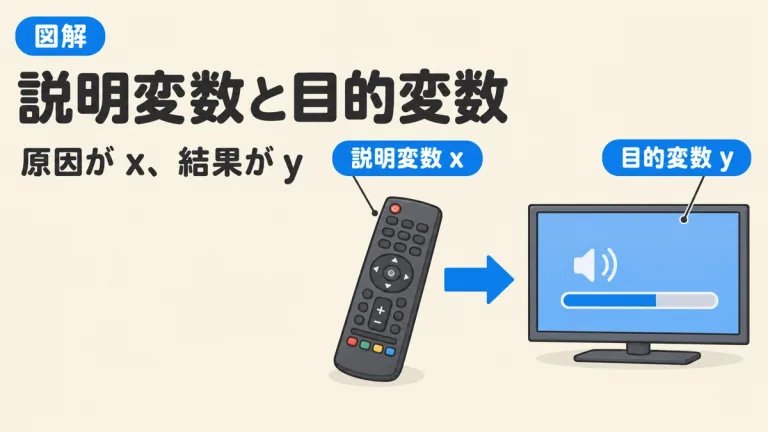
説明変数(x)と目的変数(y)|どっちが原因か
回帰分析では、データを2つの役割に分けます。これを最初に押さえると、後がラクです。
説明変数 x(原因)
予測の「手がかり」にする方。自分で動かせることが多い。
例:気温、勉強時間、広告費
目的変数 y(結果)
予測「したい」方。知りたいゴール。
例:アイスの売上、点数、来客数
「x で y を説明する」と言葉にすると迷いません。「気温(x)で売上(y)を説明する」はOKですが、「売上(x)で気温(y)を説明する」は不自然ですよね。原因がx、知りたい結果がyです。
まずは「点の雲」を見る|散布図ガイド
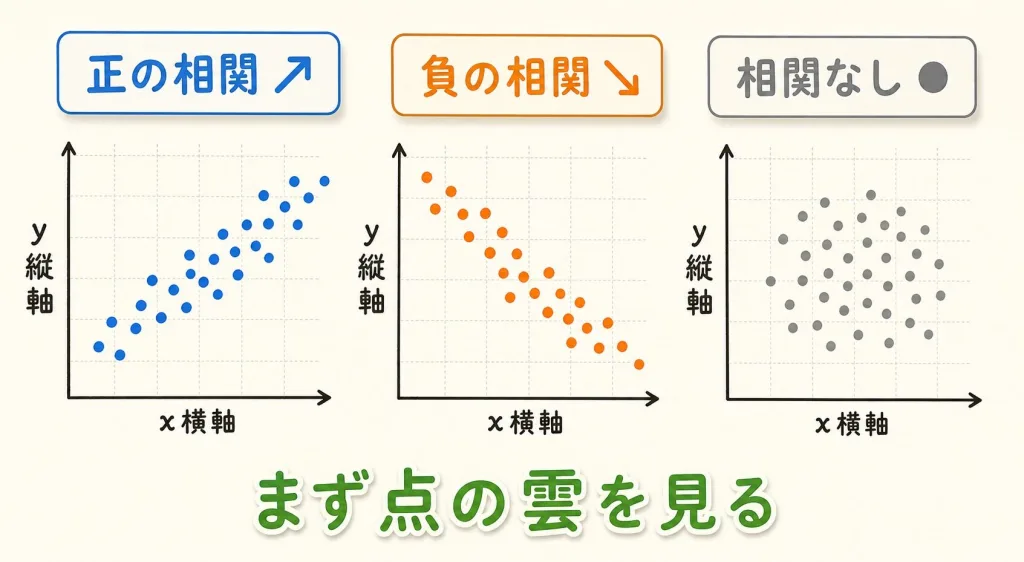
回帰分析を始める前に、必ずやることがあります。それが散布図を描いて、データの「点の雲」を眺めることです。散布図は、2つのデータの関係を「点」で表したグラフです。
・横軸(x)に説明変数(例:気温)
・縦軸(y)に目的変数(例:売上)
あとは、1日ぶんのデータを1つの点として打っていくだけ。点の集まりの「形」から、関係が見えてきます。
3つの基本パターン
| 点の雲の形 | 関係 | 意味 |
|---|---|---|
| 右上がり ↗ | 正の相関 | xが増えるとyも増える |
| 右下がり ↘ | 負の相関 | xが増えるとyは減る |
| バラバラ・丸い ● | 相関なし | xとyに関係が見えない |
なぜまず散布図を描くのか。それはぽつんと離れた「外れ値」や、直線では表せない「曲がった関係」を見つけるためです。計算だけ先に進めると、これらを見逃します。「数字を出す前に、まず目で見る」が鉄則です。
相関と回帰の違い|「強さを測る」vs「式で予測する」
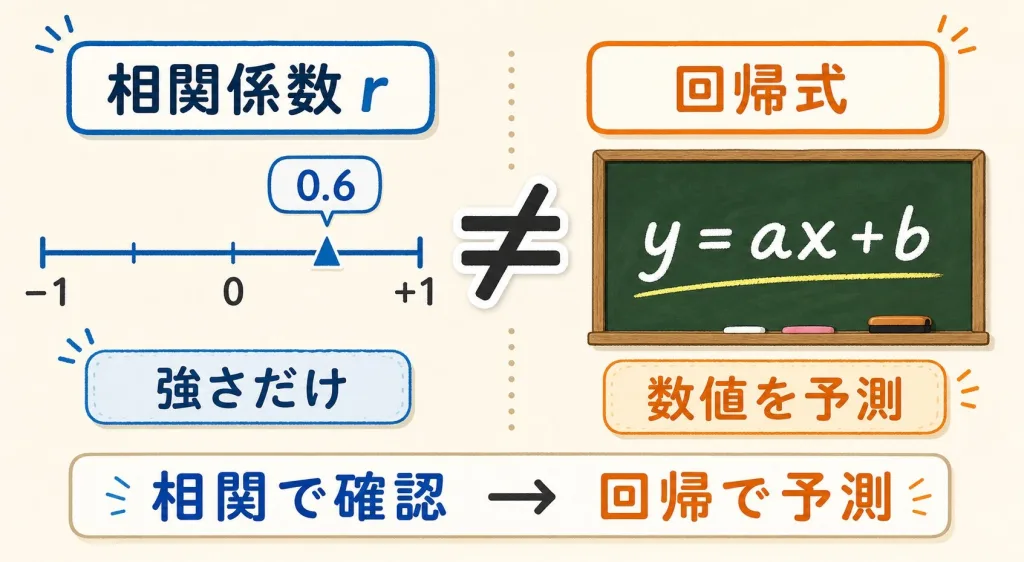
ここが本記事の核心です。散布図で「関係がありそう」とわかったら、次の2つの道具を使い分けます。
相関分析
関係の「強さと向き」を1つの数値で表す。
- 道具:相関係数 r(−1〜+1)
- わかること:「関係が深いか」
- x・yに上下関係なし(対等)
回帰分析
関係を「式」にして、yを予測する。
- 道具:回帰式 y=ax+b
- わかること:「いくつになるか」
- x(原因)→y(結果)の向きあり
相関係数 r の読み方
相関係数 r は−1から+1までの値をとり、関係の強さを表します。プラスなら右上がり、マイナスなら右下がり、0に近いほど関係が弱いという意味です。
| |r| の目安 | 関係の強さ |
|---|---|
| 0.7 〜 1.0 | 強い相関 |
| 0.4 〜 0.7 | 中程度の相関 |
| 0 〜 0.4 | 弱い・ほぼ相関なし |
「相関係数が高いなら、それで十分では?」と思いますよね。でも、相関係数は「どれくらい強いか」しか教えてくれません。
「気温が1℃上がったら、売上は何円増えるのか」という具体的な数字(予測)が欲しいなら、回帰分析が必要です。相関は関係の有無を確かめる入口、回帰は予測を出す本番、という役割分担です。
回帰の主役|単回帰の式 y=ax+b と「線形」とは
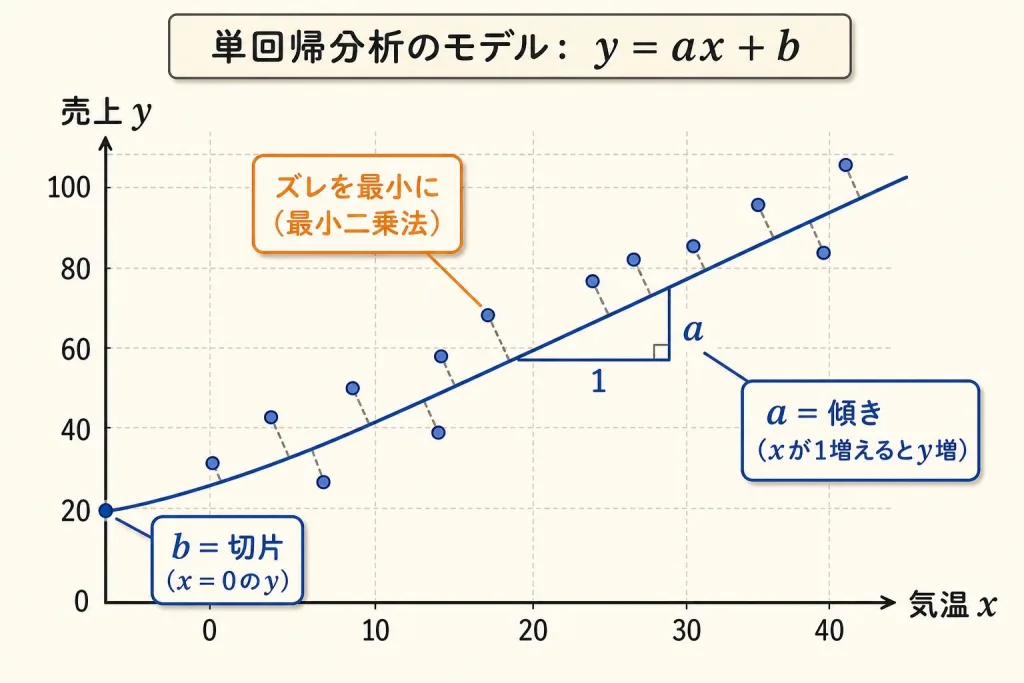
1つの説明変数(x)で1つの目的変数(y)を予測するのが単回帰分析です。使う式は、中学で習った直線の式とまったく同じです。比例 y=ax との違いは、切片 b が自由に動くことだけ。だから「気温0℃でもアイスは少しは売れる」といった、現実に合う線が引けます。
y = ax + b
a:傾き(回帰係数)/ b:切片
この式の a と b には、ちゃんとした意味があります。
a(傾き)
xが1増えると、yがどれだけ増えるか。
例:気温が1℃上がると売上が500円増える → a=500
b(切片)
xが0のときのyの値。
例:気温0℃でも売れる基本の売上
式が y = 500x + 2000 だとします(a=500、b=2000)。
気温 x=25 を代入すると → y = 500×25 + 2000 = 12500 + 2000 = 14,500円
このように、式さえできれば、まだ起きていない日の売上も予測できます。これが回帰の力です。
傾きと切片を読むときの3つのコツ
- 傾きは単位つきで読む。おでんの売上が y=−10x+300(x:気温℃、y:個)なら、傾き−10は「気温が1℃上がると、売上が10個減る」という意味です。符号が向き、大きさが効き方の強さを表します。0に近ければ、xが変わってもyはほとんど変わりません。
- 傾きの数字だけで、要因どうしをくらべない。傾きの大きさは単位で変わります(気温を0.1℃きざみにすれば数字も変わる)。単位のちがう要因の効き方をくらべるときは、標準化した係数を使います。
- 切片は、x=0がデータの範囲にあるときだけ意味をもつ。切片は「x=0のときの予測値」です。気温0℃の日のデータがないのに、切片の300個を「0℃の日の売上」と読むのは、データの外への当てはめ(外挿)です。広告費のように0が自然な範囲に入るときは、「何もしなくても出る基本の量(ベースライン)」として読めます。
「線形」とは何か|なぜ世界を直線で説明するのか
回帰分析でよく出る「線形(リニア)」という言葉。これは単純に「直線で表せる関係」という意味です。y=ax+b が直線の式だから「線形回帰」と呼びます。
現実の関係は、本当はゆるやかに曲がっているかもしれません。それでも直線で近似するのは、「シンプルで、誰でも解釈でき、計算しやすい」からです。
「xが1増えればyがa増える」という直線は、人間が一番理解しやすい形です。まず直線で大づかみにとらえる——これが線形回帰の発想です。
どうやって直線を引く?|最小二乗法のイメージ
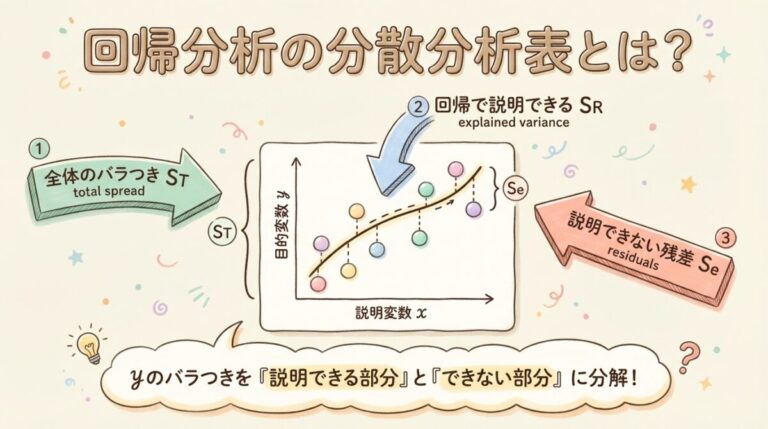
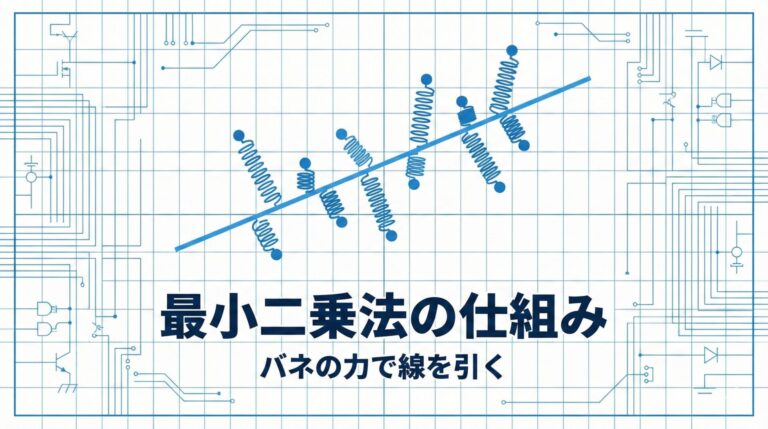
点の雲のどこに直線を引くか。正解は「各点から直線までのタテのズレ(残差)の2乗を、合計して一番小さくする直線」です。これを最小二乗法といいます。
各点と直線をバネでつないだと想像してください。バネが引っ張る力(ズレ)の合計が最小になる位置で、直線がピタッと安定します。これが最小二乗法で引かれる回帰直線です。
例題で確かめる|気温とアイスの売上から回帰直線を作る
5日分のデータで、実際に傾き a と切片 b を求めてみます。手順は「平均を出す → 平均からのズレを掛けて足す → 割る」の3つだけです。
| 日 | 気温 x(℃) | 売上 y(個) | x−x̄ | y−ȳ | (x−x̄)(y−ȳ) | (x−x̄)² |
|---|---|---|---|---|---|---|
| 1 | 20 | 150 | −6 | −70 | 420 | 36 |
| 2 | 22 | 180 | −4 | −40 | 160 | 16 |
| 3 | 26 | 230 | 0 | 10 | 0 | 0 |
| 4 | 28 | 250 | 2 | 30 | 60 | 4 |
| 5 | 34 | 290 | 8 | 70 | 560 | 64 |
| 合計 | 130 | 1100 | 0 | 0 | 1200 | 120 |
① 平均:x̄ = 130 ÷ 5 = 26℃、ȳ = 1100 ÷ 5 = 220個
② 傾き:a = Σ(x−x̄)(y−ȳ) ÷ Σ(x−x̄)² = 1200 ÷ 120 = 10
③ 切片:b = ȳ − a x̄ = 220 − 10 × 26 = −40
回帰直線は y = 10x − 40。気温30℃の日なら y = 10 × 30 − 40 = 260個と予測できます。
・傾き 10:気温が1℃上がると、売上は約10個増える。
・切片 −40:気温0℃のときの「式の上の値」。データは20〜34℃なので、これを「0℃の日の売上」とは読みません(データの外への当てはめ=外挿)。
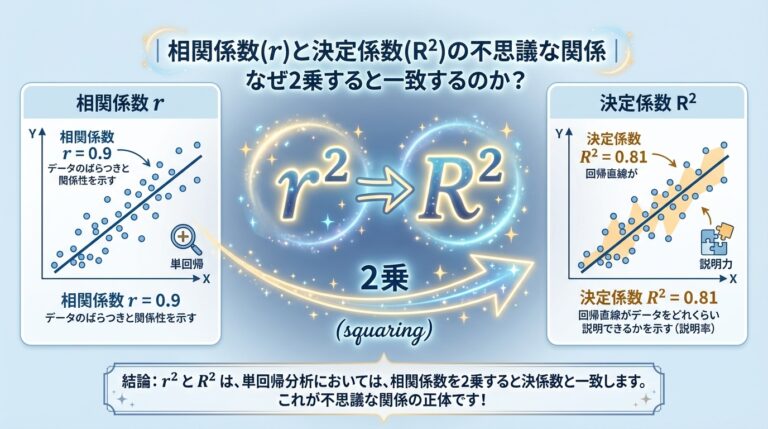
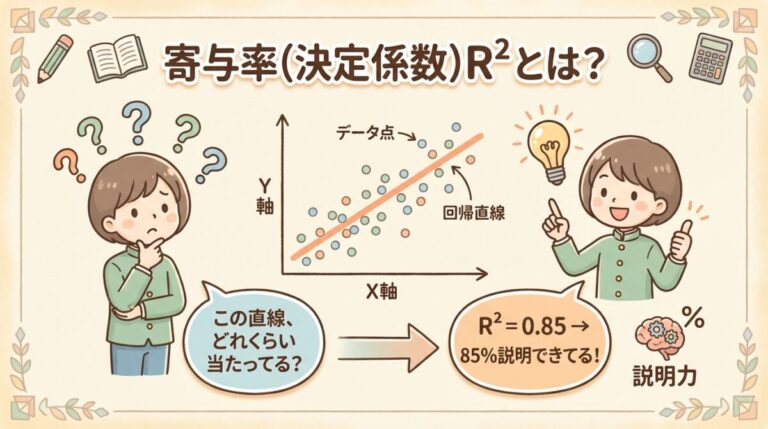
・決定係数 R²:直線がデータのばらつきをどれだけ説明できたかの割合で、R² = 1 − 残差平方和 ÷ 総平方和 で求めます。この例では、各日の残差(実測 − 予測)は −10・0・10・10・−10 で残差平方和は 400、総平方和 Σ(y−ȳ)² は 12,400 なので、R² = 1 − 400 ÷ 12,400 ≒ 0.97。売上のばらつきの約97%は気温で説明できる、という意味です。
傾きと切片の公式がなぜこの形になるのかと、数字を入れるだけで計算できるツールは最小二乗法とは?回帰直線の求め方を例題で図解(計算ツール付き)にあります(この記事では ŷ=a+bx と書いていて、a と b の役割が入れかわります。記号ではなく「傾き」「切片」で覚えると迷いません)。R² の意味と目安は決定係数R²とは?意味・求め方・目安で詳しく図解しています。
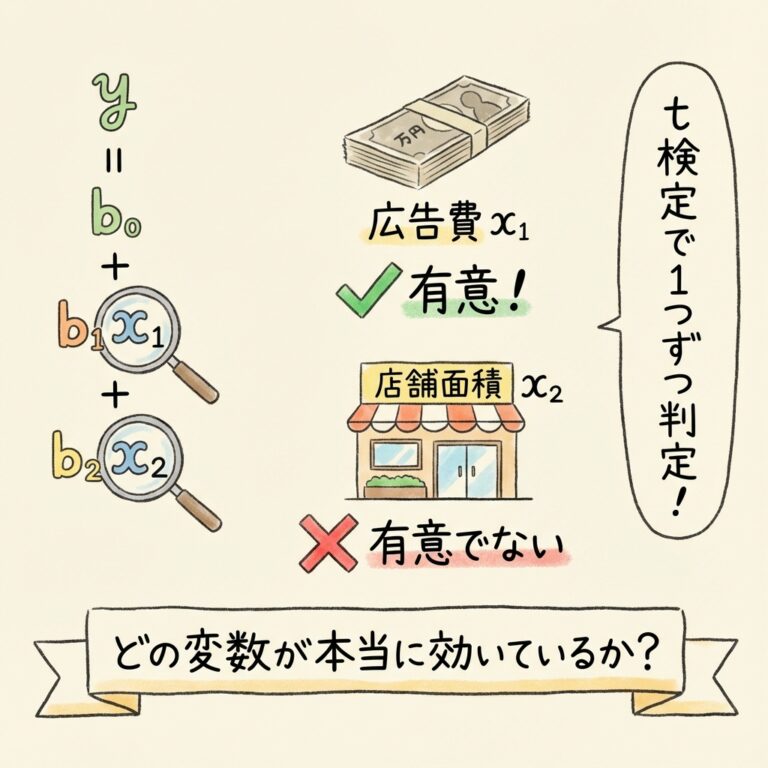
説明変数が2つ以上になると「重回帰分析」です。式が ŷ=b₀+b₁x₁+b₂x₂+… と伸びるだけで、考え方は同じです。進め方と結果の見方は重回帰分析とは?意味・やり方・結果の見方(計算ツール付き)、単回帰・重回帰の式をまとめて見たいときは回帰分析の公式一覧が便利です。
| 比較 | 単回帰分析 | 重回帰分析 |
|---|---|---|
| 説明変数の数 | 1つ | 2つ以上 |
| 式 | y = ax + b | ŷ = b₀ + b₁x₁ + b₂x₂ + … |
| 例 | 気温 → 売上 | 気温・曜日・広告費 → 売上 |
| 向いている場面 | 1つの要因の効き方を見たい | 複数の要因の効き方を分けて見たい |
| 注意点 | 外挿・擬似相関 | 説明変数どうしの相関(多重共線性)。回帰診断で点検 |
説明変数(x)と目的変数(y)の違いとは?どっちが原因か迷わない覚…
回帰分析を信じる前に|4つの前提条件
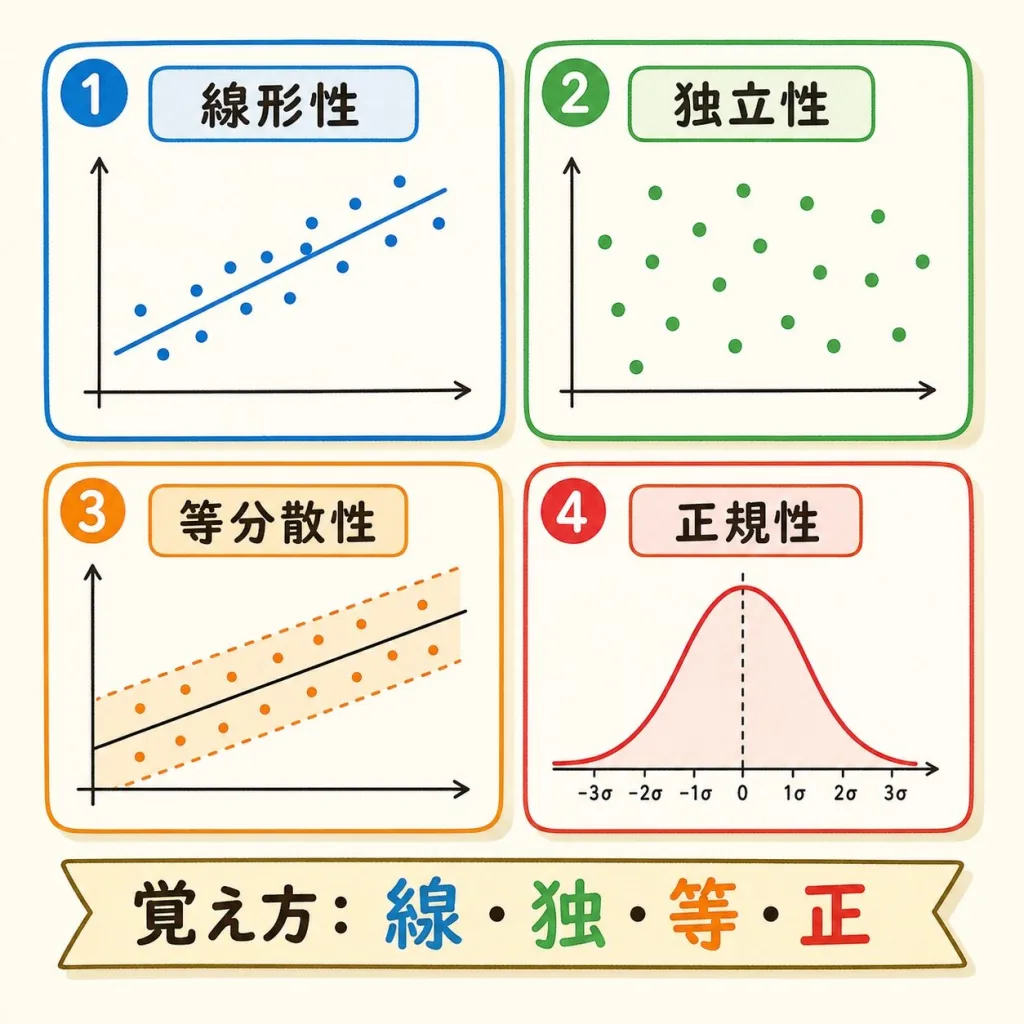
回帰分析の結果を信頼するには、守られているべき4つの前提があります。これを無視すると、出した予測が当てにならなくなります。難しそうですが、1つずつ見れば単純です。
線形性:xとyの関係が「直線」で表せること。曲がった関係に直線を当てると当然ズレる。→ 散布図で確認。
独立性:各データが互いに影響しあっていないこと。「前の日の結果が次に響く」ようなデータは要注意。
等分散性:ズレ(残差)のバラつきが、xの大小にかかわらず一定であること。xが大きいほどバラつくのはNG。
正規性:ズレ(残差)が、平均0の正規分布に従っていること。極端に偏ったズレ方をしていないか。
線形性・独立性・等分散性・正規性の頭文字。多くは「残差プロット(ズレを散布図にしたもの)」を見れば、まとめてチェックできます。
「アイスが売れると水難事故が増える」——これは両方とも「気温」が原因で、アイスが事故を起こすわけではありません。相関があっても、因果関係(原因と結果)とは限らない。これを擬似相関(見せかけの相関)といいます。回帰式が出ても、本当に原因と結果かは別途考える必要があります。
内挿と外挿|回帰式はデータの範囲の外では信用できない
回帰式で予測するとき、x の値がデータを取った範囲の内側か外側かで、予測の信用度が大きく変わります。範囲の内側での予測を内挿、外側での予測を外挿といいます。
| 内挿 | 外挿 | |
|---|---|---|
| 意味 | データの x の範囲の中で予測する | データの x の範囲の外で予測する |
| 例(20〜60℃で測ったデータ) | 40℃のときの値 | 100℃のときの値 |
| 信用度 | 比較的高い | 低い。式の形そのものが成り立つ保証がない |
外挿が危ない理由は2つあります。1つ目は、直線の関係が範囲の外でも続くとは限らないことです。20〜60℃では直線に見えても、80℃を超えると材料が軟らかくなって急に曲がる、といったことは珍しくありません。2つ目は、予測の幅(予測区間)が x̄ から離れるほど広がることです。予測区間の式には (x₀−x̄)² が入っているので、データの中心から遠い x₀ ほど誤差が大きくなります。
回帰式は「データを取った範囲の中」で使う道具。範囲の外の値を知りたいときは、その条件で実際にデータを取って確かめる。
予測の精度|信頼区間と予測区間の違い
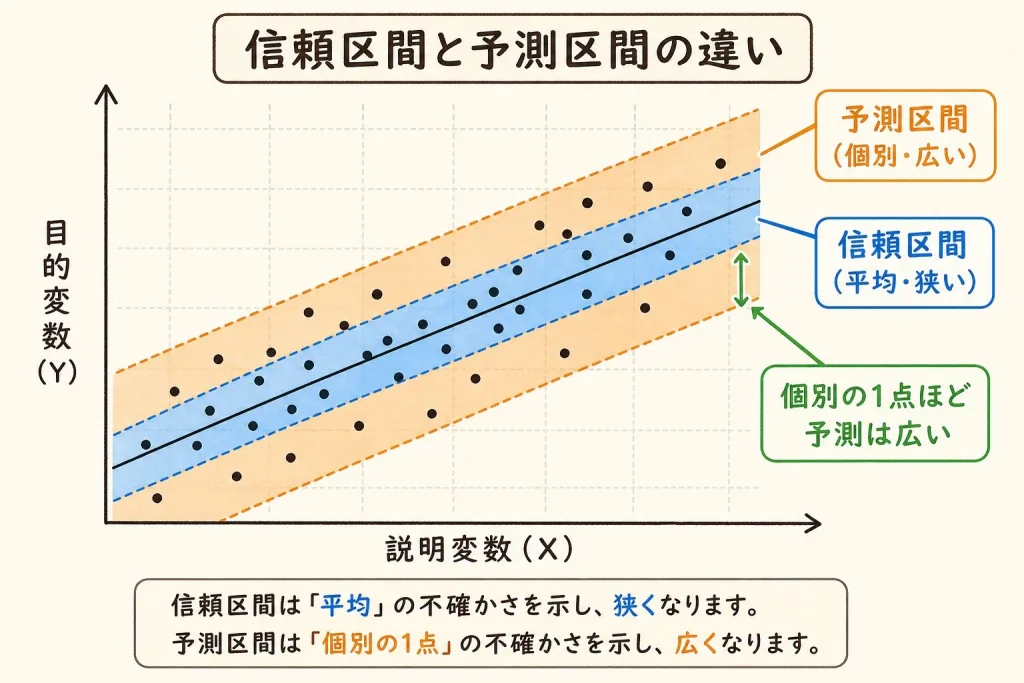
回帰直線で予測しても、ピタリと当たることはまずありません。そこで「だいたいこの範囲」という幅をつけます。この幅に2種類あるのが、多くの人が混乱するポイントです。
信頼区間
「平均的にはどのへんか」の範囲。
- 例:気温25℃の日「全体の平均売上」はどこか
- 狙うのは「平均の位置」
- 幅は狭い
予測区間
「次の1つはどこに来るか」の範囲。
- 例:気温25℃の「明日1日の売上」はどこか
- 狙うのは「個別の1点」
- 幅は広い
「平均」は、たくさんの日をならした値なのでブレが小さい(=信頼区間は狭い)。
でも「明日という特定の1日」は、その日だけのバラつき(運・誤差)が乗るので、予測の幅が広がります(=予測区間は広い)。
個別の1点を当てるほうが難しいから、予測区間は信頼区間より必ず広くなります。
| 比較 | 信頼区間 | 予測区間 |
|---|---|---|
| 知りたい対象 | yの「平均」 | yの「個別の1点」 |
| 幅 | 狭い | 広い |
| 使う場面 | 傾向・平均を語る | 明日の実測を見積もる |
どちらの区間も、データのある範囲(内挿)でしか信頼できません。気温0〜30℃のデータから作った式で「気温50℃」を予測する(外挿)のは危険です。データのない世界では、直線が成り立つ保証がないからです。
よくある質問(FAQ)
A. 原因のデータ(x)から結果(y)を、式 y=ax+b で予測する方法です。相関は関係の強さを測り、回帰は「いくつになるか」を出します。
A. 「関係があるか確かめたい」なら相関、「具体的な数値を予測したい」なら回帰です。まず相関で関係を確認し、次に回帰で予測するのが王道です。
A. 相関係数は「関係の強さ」を示すだけで、予測値そのものは出しません。具体的な予測には回帰式(y=ax+b)が必要です。
A. 「直線で表せる関係」という意味です。y=ax+b が直線の式なので、これを使う回帰を線形回帰と呼びます。
A. 回帰直線がデータのばらつきをどれだけ説明できたかの割合です。1に近いほど当てはまりがよく、0.97 なら約97%を説明できています。
A. 予測区間のほうが広いです。平均を当てる信頼区間より、個別の1点を当てる予測区間のほうが不確かさが大きいためです。
A. 説明変数が2つ以上になると「重回帰分析」になります。基本の考え方は単回帰と同じで、式に項が増えるだけです。
まとめ:相関と回帰の基礎はこれで完成
- 相関=関係の強さを r(−1〜+1)で測る/回帰=関係を式 y=ax+b にして予測する
- 分析の前に必ず散布図を描き、外れ値や曲がりを目で確認する
- 単回帰の式は a=傾き(xが1増えるとyがa増える)、b=切片
- 「線形」=直線で表せる関係。最小二乗法でズレが最小の直線を引く
- 例題:気温とアイスの売上なら y=10x−40。決定係数 R²は「ばらつきのうち直線で説明できた割合」(例題では約0.97)
- 前提は線・独・等・正の4つ/予測区間は信頼区間より広い
ここまで理解できれば、回帰分析の土台は完成です。次は決定係数R²や、説明変数を増やす重回帰分析に進むと、一気に実戦的になります。
回帰分析の考え方を、楽しく復習したいときに向いています。回帰分析の考え方を、マンガで解説した本です(オーム社)。

「相関と回帰分析の基礎」の土台になる統計学を、本でじっくり学び直したいときに向いています。統計学を独学で学べるように書かれた入門書です(ダイヤモンド社、小島寛之 著)。

メーカーで電気設計と品質保証に携わってきた経験をもとに執筆しています。むずかしい専門用語をできるだけ使わず、はじめて学ぶ人がつまずかないように、図とたとえで説明することを大切にしています。
次に読むべき記事
この記事の内容がわかったら、単回帰分析の次のテーマに進みましょう。続けて読むと、現場でそのまま使える知識になります。

テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめて学ぶ人向けにやさしく書いています。