
- 回帰分析はできたけど、この結果を信じていいのか自信がない
- 決定係数R²が高ければそれでOK…じゃないの?
- 「残差プロット」「VIF」「クックの距離」…名前だけ聞いたことがある
- 係数がマイナスになった。計算ミス?それとも何か問題がある?
- 回帰診断とは何をする作業なのか
- 残差プロットの見方(ランダムならOK・広がったら危険)
- 正規確率プロットで正規性を確かめる方法
- VIFの計算と「10」という目安の意味
- てこ比・クックの距離で1点の影響を見つける方法
- R*²・Cp・AICでモデルを比べる基準
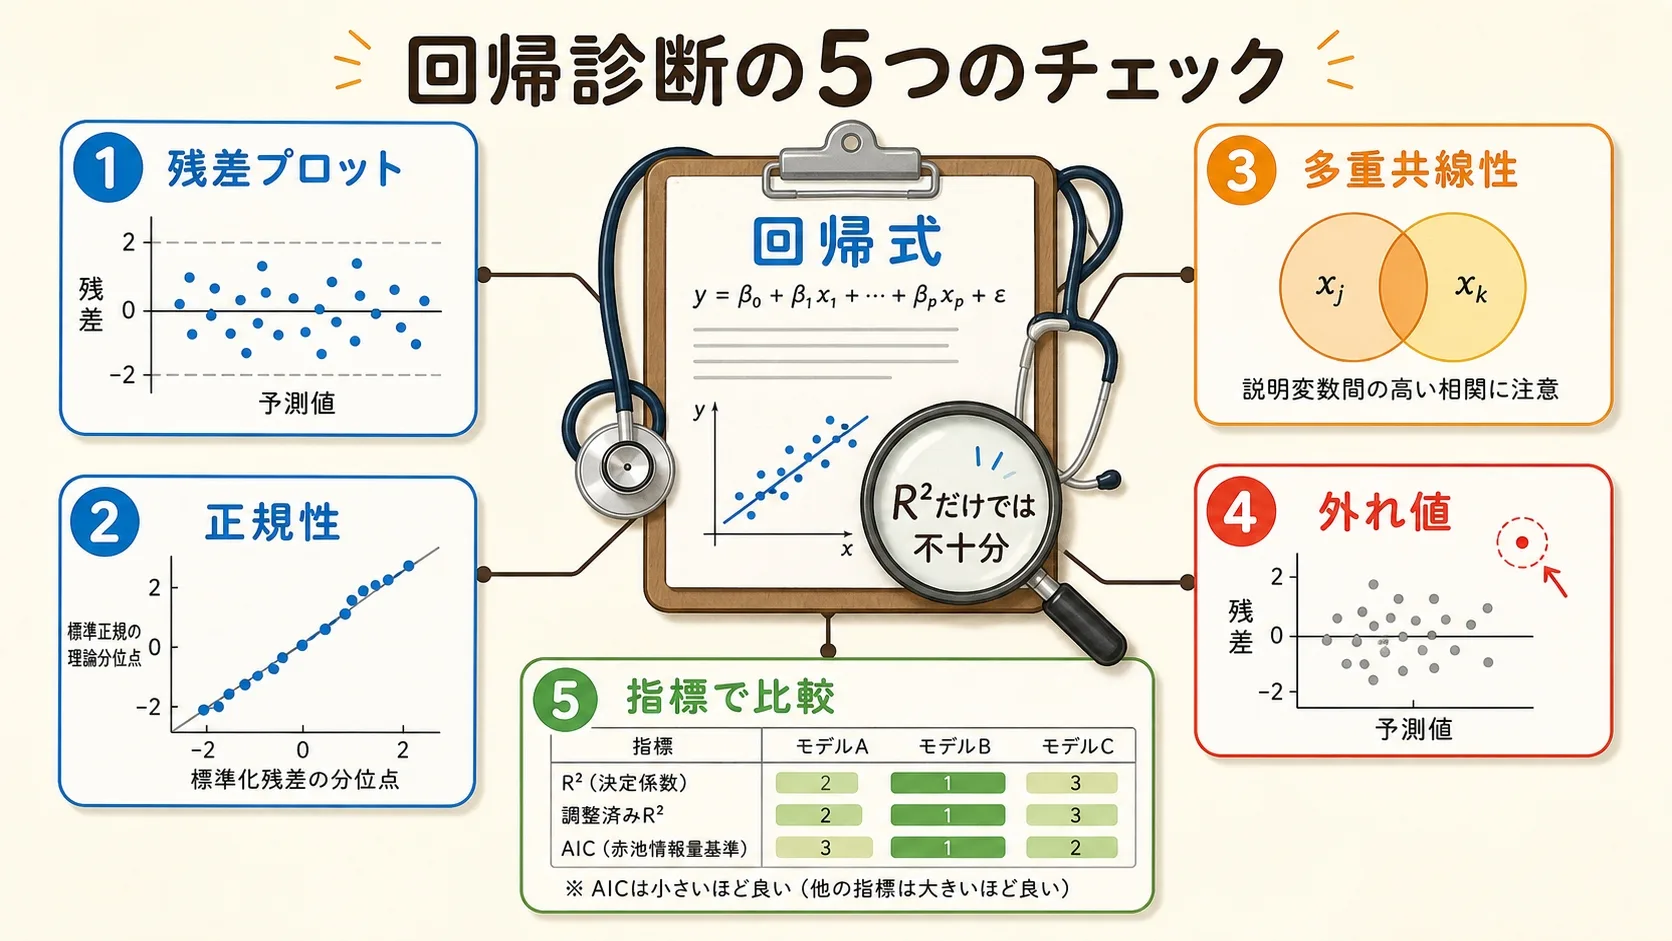
回帰診断とは、回帰分析で出てきた式が信頼できるかどうかを、あとから点検する作業です。点検する場所は5つあります。①残差(実際の値と予測値のズレ)の散らばり方、②残差の正規性、③多重共線性(説明変数どうしが似すぎていないか。VIF>10で疑う)、④外れ値と影響の大きい点(てこ比・クックの距離)、⑤変数選択の指標(自由度調整済み寄与率R*²・Cp統計量・AIC)です。決定係数R²が高いだけでは「良いモデル」とは言えません。
「Excelで回帰分析のボタンを押したら、数字がたくさん出てきた。R²は0.92。よし、いい感じだ」
——ここで終わってしまうと、実はかなり危険です。
回帰分析には、いくつかの「前提」があります。その前提が崩れていると、R²が高くても予測は当たりません。そして前提が崩れていることは、R²の数字を見ているだけでは絶対にわかりません。
そこで必要になるのが「回帰診断」です。この記事では、専門用語をすべてその場で噛み砕きながら、5つの点検ポイントを順番に見ていきます。はじめは名前がとっつきにくいですが、やること自体はとてもシンプルです。
そもそも回帰診断とは?回帰式の「健康診断」です
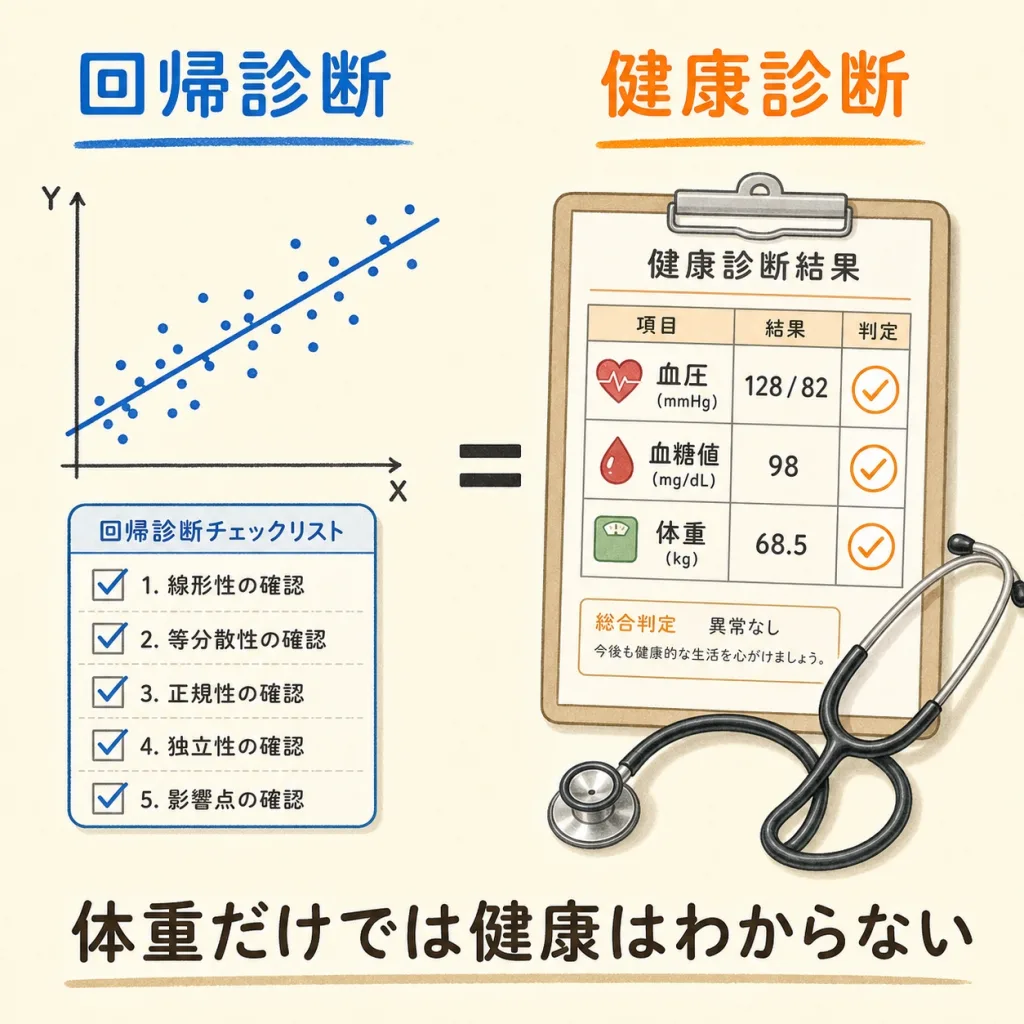
回帰診断(かいきしんだん)とは、できあがった回帰式が「使っていい状態か」を確かめる点検作業です。英語ではregression diagnostics。「診断」という名前のとおり、やっていることは人間の健康診断とほとんど同じです。
体重が標準だからといって、健康だとは限りませんよね。血圧・血糖値・肝臓の数値も見ないと、本当の健康状態はわかりません。
回帰分析における体重が「決定係数R²」です。ひとつの目安にはなりますが、それだけでは不十分。血圧や血糖値にあたるのが、これから紹介する残差プロットやVIFなどの診断項目です。
なぜ診断が必要?回帰分析には「4つの前提」がある
回帰分析は、次の4つが成り立っていることを前提に計算されています。前提が崩れると、出てくる数字の意味が変わってしまいます。
| 前提 | やさしく言うと | 崩れたら? |
|---|---|---|
| 線形性 | xとyの関係が直線でよく表せる | 直線であてはめるのが間違い |
| 等分散性 | ズレの大きさがどこでも同じくらい | 検定や区間推定が信用できない |
| 正規性 | ズレが山型(正規分布)に散らばる | p値や信頼区間がずれる |
| 独立性 | データ同士が影響し合っていない | 精度を過大評価してしまう |
「等分散性」「正規性」——いきなり難しい言葉が出てきましたが、心配いりません。この4つはほぼ全部、たった1枚の残差プロットとにらめっこするだけで確認できます。次の章から実際に見ていきます。
回帰診断は「回帰式が前提を守れているか」を確かめる作業です。診断項目は5つ。①残差の散らばり ②残差の正規性 ③多重共線性 ④外れ値と影響点 ⑤変数選択の指標。この順番で点検すれば、抜けがありません。
診断①:残差の検討|残差プロットは「ランダムに散らばっていればOK」
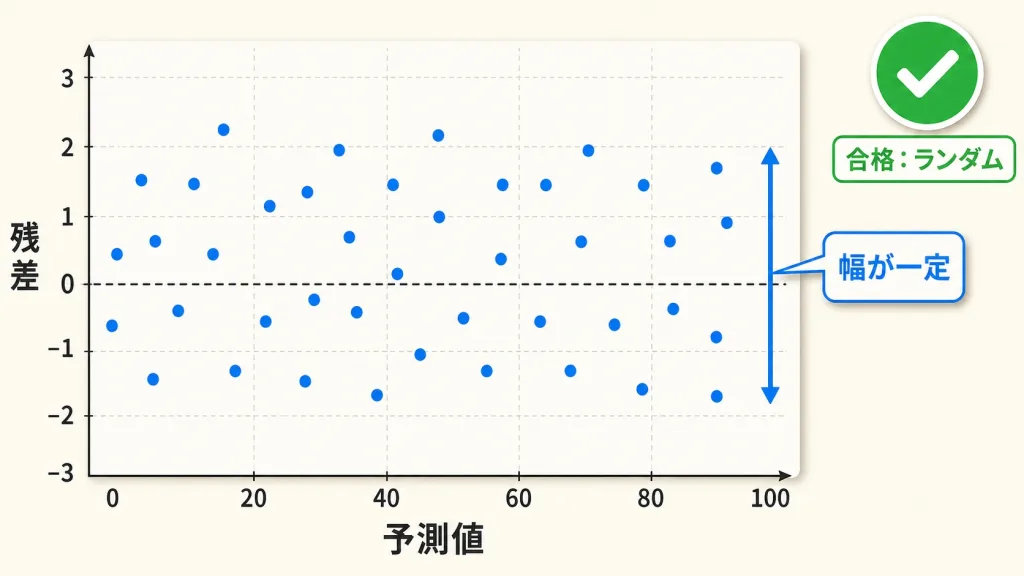
残差プロットとは、横軸に予測値、縦軸に残差(実際の値 − 予測値のズレ)をとった散布図です。点がランダムにバラバラに散らばっていれば合格、何かの模様(パターン)が見えたら要注意です。
残差とは「予測の外し方」
まず残差の意味をはっきりさせます。残差は、たったこれだけの計算です。
残差 = 実際の値 − 予測値
たとえば、ある日の売上を回帰式で予測したら「100万円」。実際の売上は「108万円」でした。このとき残差は——
残差 = 108 − 100 = +8万円。
予測より実際が多ければプラス、少なければマイナスになります。つまり残差は「予測の外し方の記録」です。残差と誤差の細かい違いが気になった方は、残差と誤差の違いもあわせて確認してみてください。
なぜ「ランダムなら合格」なのか
ここが回帰診断でいちばん大事な考え方です。理由はシンプルです。
もし残差に規則性(パターン)が残っているなら、それは「まだ回帰式が拾えていない情報が残っている」という証拠です。ちゃんと説明しきれていれば、残るのは説明のつかないランダムな誤差だけになるはずですよね。
部屋を掃除したあと、床にホコリがまばらに少し残っているのは自然です。これがランダムな残差。
でも、ゴミが一列にきれいに並んで残っていたら「掃除の仕方が間違っている」とわかりますよね。残差のパターンは、まさにこの「並んだゴミ」なのです。
残差プロットの作り方(Excelでもできます)
回帰分析を実行して、各データの予測値を出します(Excelの分析ツールなら「残差」出力にチェックを入れるだけで一覧が出ます)。
各データで「実際の値 − 予測値」を計算し、残差の列をつくります。
横軸に予測値、縦軸に残差をとって散布図を描きます。縦軸0の高さに水平線を引くと、上下のバランスが見やすくなります。
「0の線をはさんで、上下に同じくらい、同じ幅で、意味もなくバラバラに散らばっている」。この状態が理想です。つまらない絵に見えるのが、いちばん良い残差プロットです。
残差プロットの形で原因がわかる|曲線なら非線形、右に広がれば不等分散
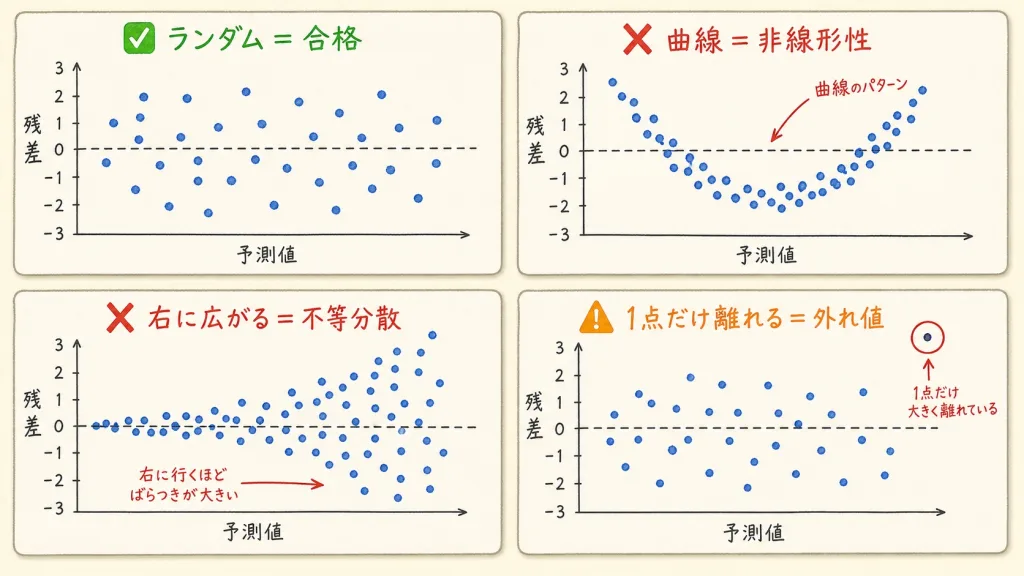
残差プロットは、点の並び方の「形」で問題の種類まで教えてくれます。曲線を描いていれば非線形性、右に向かってラッパのように広がっていれば等分散性が崩れている(不等分散)サインです。代表的な4パターンを覚えておけば、ほぼ判断できます。
パターン別・早見表
| 点の並び方 | 判定 | 意味 | 対処のヒント |
|---|---|---|---|
| バラバラにランダム | ✅ 合格 | 前提が守られている | そのまま進んでOK |
| U字・逆U字の曲線 | ❌ 非線形性 | 直線であてはめるのが不適切 | 2乗項を追加、対数をとる |
| 右へ向かって扇状に広がる | ❌ 不等分散 | 値が大きいほどズレも大きい | yの対数をとる、重み付き回帰 |
| 波を打つ・連続して同じ側に並ぶ | ❌ 独立性の崩れ | 時間的な影響が残っている | 時系列の手法を検討する |
| 1点だけ極端に離れている | ⚠️ 外れ値の疑い | 特殊な事情があるデータかも | クックの距離で影響を確認 |
曲線パターン=「非線形性」をやさしく理解する
非線形性(ひせんけいせい)とは、xとyの関係が直線ではない、ということです。
たとえば「広告費と売上」を考えてみます。広告費を10万円から20万円に増やせば売上はぐんと伸びるでしょう。でも、1000万円から1010万円に増やしても、ほとんど変わらないはずです。
つまり、この関係は途中で伸びが鈍る曲線です。それを無理に直線であてはめると、真ん中では予測が高すぎ、両端では低すぎる——というU字の食い違いが残差に現れます。
カーブした道に、まっすぐな定規を当ててみてください。真ん中はぴったり付いても、両端は必ず浮きますよね。
その「浮いた分」が残差です。浮き方が規則的にU字になるので、「あ、この道はカーブしているんだな」とわかるわけです。
右に広がるパターン=「不等分散」をやさしく理解する
等分散性(とうぶんさんせい)とは、「ズレの大きさがどこでも同じくらい」という前提です。これが崩れた状態を不等分散(ふとうぶんさん)と呼びます。
身近な例で考えます。月の売上が100万円のお店なら、予測のズレは数万円でしょう。でも売上が1億円の店なら、ズレは数百万円になります。
つまり「大きい数字ほど、ズレも大きくなる」のです。これを残差プロットにすると、右に行くほど点の上下の幅が広がり、横向きのラッパのような形になります。
不等分散があっても、回帰係数そのものは大きくは狂いません。狂うのは「その係数がどれくらい信用できるか」の部分です。p値や信頼区間が実際より甘く出て、「有意な関係がある」と早合点しやすくなります。ここが見落とされやすい落とし穴です。
残差プロットは「曲線が見えたら形が違う」「広がっていたらバラつきが違う」の2つだけ覚えれば十分です。この2つが見当たらず、ただバラバラなら合格。まずはここを確認するのが回帰診断の第一歩です。
診断②:残差の正規性|正規確率プロットが直線に乗るか見る
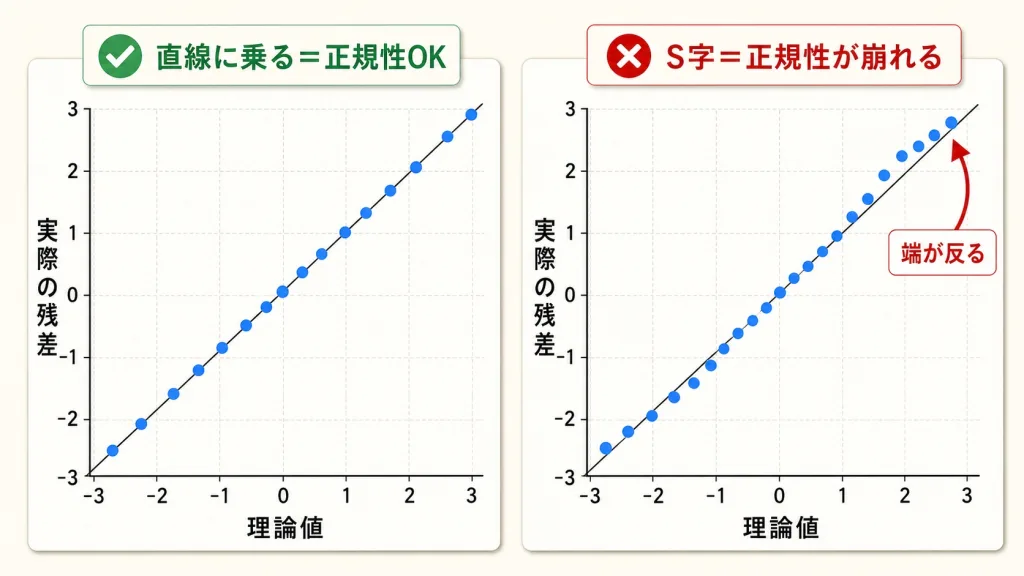
残差の正規性とは、予測のズレが「山型(正規分布)」に散らばっているかどうかです。確かめ方は、正規確率プロットを描いて点が一直線に並ぶかを見るだけです。直線に乗っていれば合格、S字やカーブを描いたら正規性が崩れています。
正規分布とは「真ん中が多く、両端が少ない」形
正規分布(せいきぶんぷ)とは、真ん中あたりの値がいちばん多く、そこから離れるほど少なくなる、左右対称の山型の分布です。
残差にこれを当てはめると、こういう状態が期待されます。
| 残差の大きさ | どれくらいの頻度で出るはず? |
|---|---|
| 0に近い小さなズレ | よくある(いちばん多い) |
| 中くらいのズレ | ときどきある |
| とても大きなズレ | まれ(ほとんど出ない) |
| プラス側とマイナス側 | だいたい同じくらい(左右対称) |
正規確率プロットは「答え合わせの並べ替え」
正規確率プロット(せいきかくりつプロット。QQプロットとも呼びます)は、少し不思議なグラフです。やっていることを言葉にすると、こうなります。
実際に出た残差を、小さい順に並べます。
「もし完全に正規分布だったら、何番目の残差はいくらになるはずか」という理論値を計算します。
横軸に理論値、縦軸に実際の値をとって点を打ちます。両者が一致していれば、点は自然に一直線に並びます。
クラス全員を身長順に並べて、「1番目は◯cm、2番目は◯cm…」という予想リストと見比べる作業に似ています。
予想どおりなら、実際と予想を並べたグラフはきれいな斜め一直線になります。どこかで大きく外れれば、そこだけ線から浮き上がります。
形で読み取る・正規性の判定
✅ 合格の形
- 点が斜め一直線に沿って並ぶ
- 端が少しずれる程度なら問題なし
- データが少ないほど、多少の乱れは自然
❌ 注意が必要な形
- S字カーブ:端のズレが理論より大きい/小さい
- 片側だけ反り上がる:左右非対称(歪んでいる)
- 端の1〜2点だけ大きく飛び出す:外れ値の疑い
正規性は、4つの前提の中ではいちばん多少の崩れが許される項目です。データ数がある程度多ければ、少しの崩れでは結論はほとんど変わりません。
逆に、はっきり崩れている場合は「外れ値が混ざっている」「yを対数に変換すべき」といった別のサインであることが多いです。正規性そのものを直すより、崩れの原因を探すほうが実りがあります。
診断③:多重共線性|VIF>10なら疑う(計算例つき)
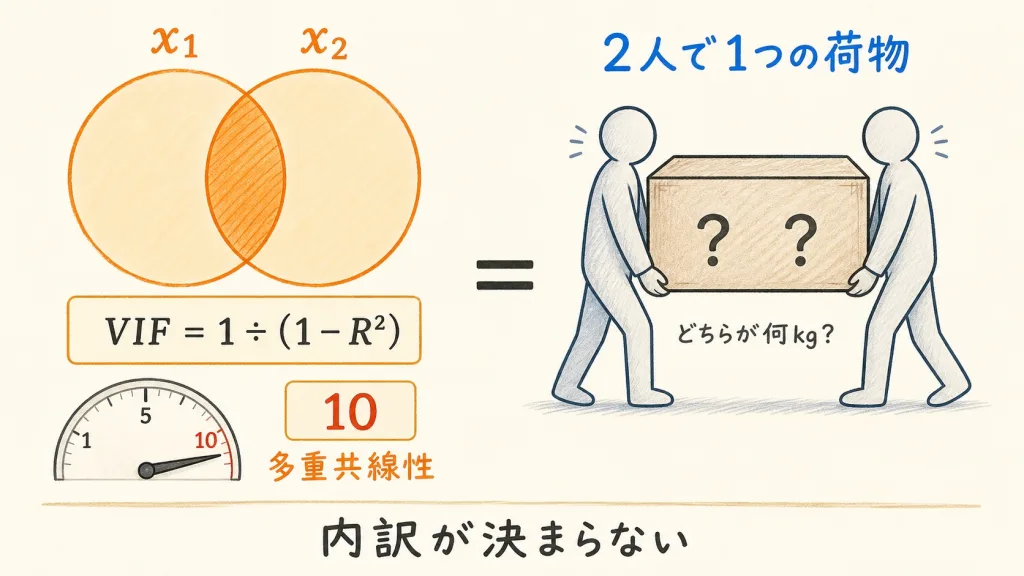
多重共線性(たじゅうきょうせんせい)とは、説明変数どうしが強く相関している状態です。これが起きると係数の符号が逆転したり、異常に大きな値になったりします。判定にはVIF(分散拡大係数)を使い、計算式は VIF = 1 ÷(1 − R²)。VIFが10を超えたら疑う、が一般的な目安です。
なぜ係数がおかしくなるのか
身長から体重を予測する式をつくるとします。説明変数に「身長(cm)」と「身長(インチ)」の2つを入れたら、どうなるでしょうか。
この2つは、単位が違うだけでまったく同じ情報です。計算する側は「体重の増加分を、どちらの変数の功績にすればいいのか」を決められません。
結果として、「身長(cm)の係数=+50、身長(インチ)の係数=−120」のような、意味不明な数字のペアが出てきます。足し合わせれば予測は当たるのに、1つずつの係数はまるで読めない。これが多重共線性です。
2人で1つの重い荷物を運んだとき、「どちらが何キロ分を持ったか」は誰にもわかりませんよね。合計は確かに運べているのに、内訳は決められません。
しかも、片方が急に力を抜けば、もう片方の負担は跳ね上がります。データが少し変わるだけで係数が大きく動くのは、まさにこの状態です。
VIFの計算式と、その意味
VIF = 1 ÷(1 − R²)
ここでのR²は「調べたい説明変数を、他の説明変数で予測したときの決定係数」
ここが少しややこしいので、ゆっくり進みます。このR²は、目的変数(売上など)とは関係ありません。
やっているのは「x₁を、x₂とx₃だけで予測できるか?」という別の回帰分析です。もしうまく予測できてしまったら、x₁は他の変数の言い換えにすぎない、ということになりますよね。
実際に手で計算してみる
R²の値を変えながら、VIFがどう跳ね上がるかを1つずつ計算します。
R² = 0.5 のとき。1 − 0.5 = 0.5。VIF = 1 ÷ 0.5 = 2。
R² = 0.8 のとき。1 − 0.8 = 0.2。VIF = 1 ÷ 0.2 = 5。
R² = 0.9 のとき。1 − 0.9 = 0.1。VIF = 1 ÷ 0.1 = 10。ここがちょうど目安のライン。
R² = 0.99 のとき。1 − 0.99 = 0.01。VIF = 1 ÷ 0.01 = 100。危険水域です。
| R²(他の変数で説明できた割合) | VIF | 判定 |
|---|---|---|
| 0(まったく無関係) | 1 | 理想的。問題なし |
| 0.5(50%) | 2 | 許容範囲 |
| 0.8(80%) | 5 | 注意して見たいレベル |
| 0.9(90%) | 10 | 多重共線性を疑うライン |
| 0.95(95%) | 20 | 対処が必要 |
| 0.99(99%) | 100 | ほぼ同じ変数を2回入れている状態 |
VIFが10ということは、R²が0.9ということ。つまり「その変数の情報の90%は、他の説明変数だけで再現できてしまう」という状態です。こう言い換えると、「それはもう入れなくていいのでは?」と自然に思えますよね。これがVIF>10で警戒する理由です。
「VIF>10」が最も広く使われますが、分野によっては「5を超えたら要注意」という基準も使われます。大事なのは数字を機械的に当てはめることではなく、係数の符号が理論と逆になっていないかを一緒に見ることです。
対処法は主に3つ。①どちらか一方の変数を削る、②2つを合成して1つの指標にまとめる、③リッジ回帰などVIFに強い手法を使う、です。
多重共線性は回帰分析でつまずく人がいちばん多いところなので、多重共線性(VIF)の詳しい解説もあわせて読むと理解が深まります。
診断④:外れ値と影響の大きい点|てこ比とクックの距離
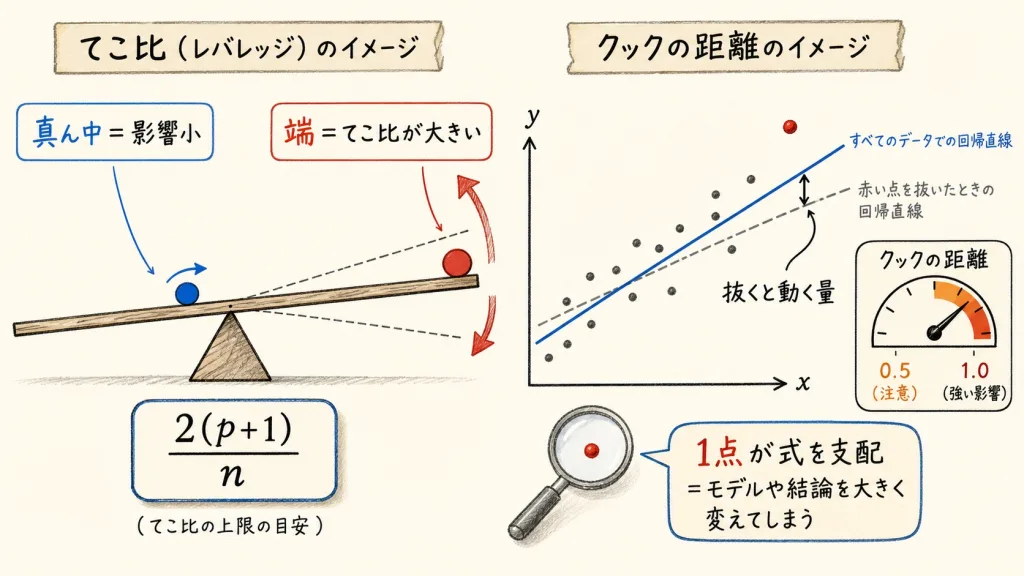
たった1つのデータが回帰式を引っ張ってしまうことがあります。それを見つけるのが、てこ比(レバレッジ)とクックの距離です。てこ比は「引っ張る力の強さ」、クックの距離は「実際にどれだけ結果が変わったか」を測ります。
「外れ値」と「影響の大きい点」は別のもの
ここは混乱しやすいので、先に整理します。似ているようで、意味が違います。
| 用語 | やさしく言うと | 回帰式は動く? |
|---|---|---|
| 外れ値 | 予測から大きく外れた点(残差が大きい) | 動くとは限らない |
| てこ比が大きい点 | xの値が他とかけ離れている点 | 動かす力を持っている |
| 影響の大きい点 | 実際に回帰式を大きく変えている点 | はっきり動く(危険) |
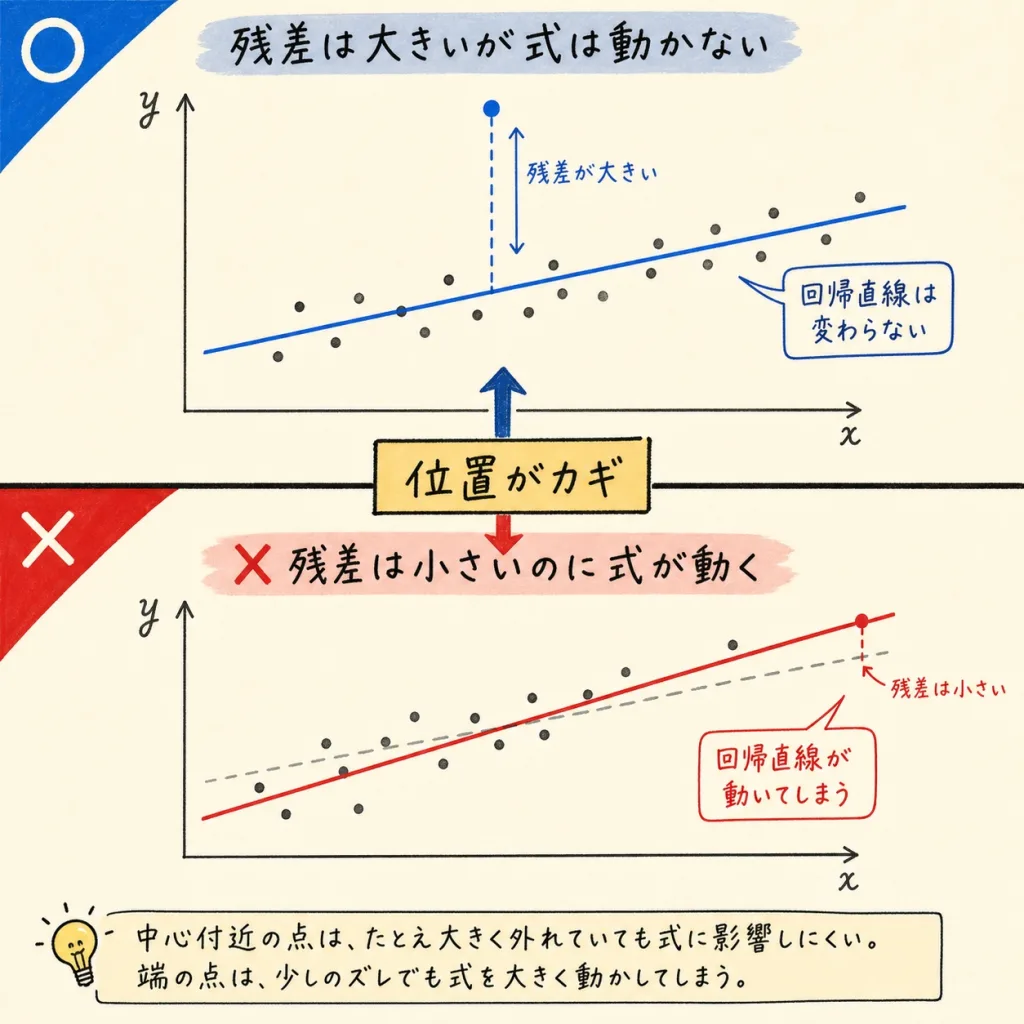
シーソーの真ん中に座っても、シーソーはほとんど傾きません。でもいちばん端に座れば、軽い人でも大きく傾かせられます。
この「端に座っている状態」が、てこ比の大きい点です。てこ比という名前は、まさにテコの原理から来ています。だから外れ値かどうかとは別に、「どこに座っているか」を見る必要があるのです。
てこ比(レバレッジ)の目安を計算する
てこ比は0から1の値で、統計ソフトが自動で計算してくれます。全データのてこ比を合計すると「説明変数の数+1」になる、という性質があるため、平均値と目安は次のように決まります。
てこ比の平均 =(p + 1)÷ n
注意すべき目安 = その2倍(または3倍)
p は説明変数の数、n はデータの件数
データ50件・説明変数2個のケースで計算してみます。
p = 2、n = 50 なので、p + 1 = 3。
てこ比の平均 = 3 ÷ 50 = 0.06。
2倍すると 0.06 × 2 = 0.12。つまり、てこ比が0.12を超えるデータには目を向けたほうがよい、ということです。
クックの距離|「抜いたら結果が変わるか」を測る
クックの距離(Cook's distance)は、考え方がとても直感的です。「そのデータを1つ抜いて回帰式を作り直したら、予測がどれだけ変わるか」を数値化したものです。
抜いても結果がほとんど変わらないなら、その点は無害。大きく変わるなら、その点が式を支配しているということです。
| クックの距離 | 一般的な解釈 |
|---|---|
| 0.5 未満 | 影響は小さい。基本的に問題なし |
| 0.5 以上 | 影響力がある。中身を確認したい |
| 1.0 以上 | 非常に大きな影響。要調査 |
なお、「4 ÷ n」を目安にする流派もあります。データ50件なら 4 ÷ 50 = 0.08 となり、0.5よりずっと厳しい基準になります。どの基準を使ったかを記録しておくことが大切です。
影響の大きい点が見つかったら、どうする?
まず入力ミスを疑います。単位の間違い、桁の打ち間違い、小数点の位置。ここで見つかることが実は多いです。
ミスでなければ特別な事情を探します。イベントがあった日、設備を交換した日、季節要因。理由が見つかれば、変数として追加できることもあります。
それでも判断できないときは、その点を入れた場合と抜いた場合の両方を計算して、結論が変わるかを確認します。変わらなければ気にしなくてよいのです。
影響の大きい点を見つけると、つい消したくなります。でも、消してよいのは「明らかな入力ミス」「測定機器の故障」など、理由をはっきり説明できる場合だけです。
正しく測れたデータを、結果が気に入らないから消す——これはデータの改ざんになってしまいます。外れ値こそが最も重要な発見であることも、実務では珍しくありません。
診断⑤:変数選択の指標|R*²・Cp統計量・AICでモデルを比べる
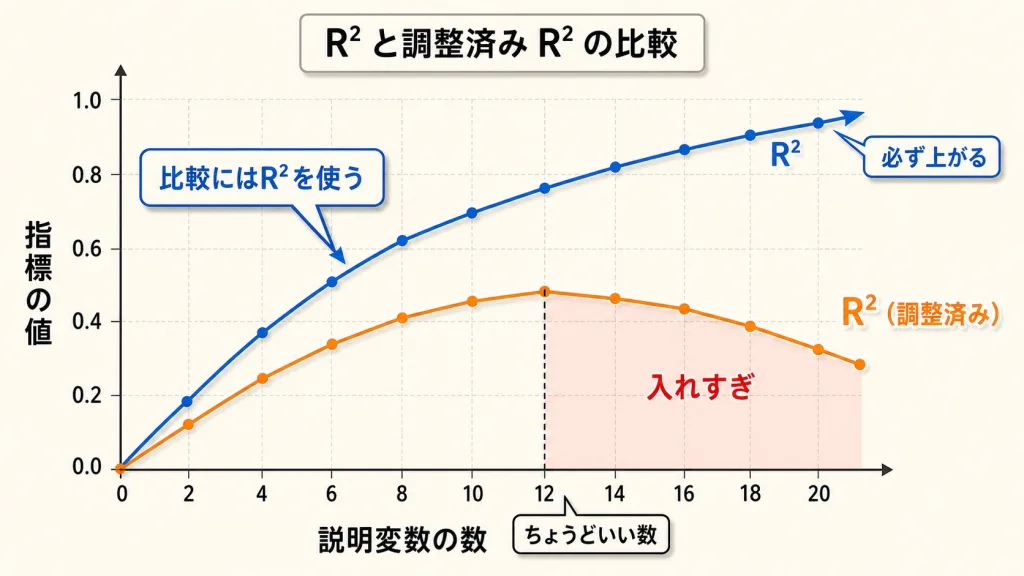
複数のモデルを比べるときは、自由度調整済み寄与率R*²、Cp統計量、AICのいずれかを使います。単なる寄与率R²は説明変数を増やせば必ず上がってしまうため、モデルの比較には使えません。ここが鉄則です。
なぜR²ではモデルを比べられないのか
寄与率R²(決定係数)は「データのバラつきのうち、回帰式で説明できた割合」です。0〜1の値で、1に近いほどよく当てはまっています。
ところが、R²には困った性質があります。意味のない変数を足しても、R²は下がらない(必ず同じか上がる)のです。
極端な例を出します。売上の予測式に「その日のサイコロの出目」を説明変数として足したとします。関係あるはずがないのに、R²はわずかに上がります。偶然の一致を拾ってしまうからです。
持ち込み可の試験で、参考書を1冊増やせば点数は下がりませんよね。100冊持ち込めば、点数は上がるかもしれません。
でも、100冊抱えた人が「私は賢い」とは言えません。「何冊持ち込んだか」を差し引いて評価する必要があります。それをやってくれるのが、次に紹介する指標たちです。
① 自由度調整済み寄与率 R*²|いちばん手軽
R*²(アールスターの2乗。調整済みR²とも書きます)は、R²から「変数を使った分のペナルティ」を差し引いた指標です。Excelの回帰分析でも「補正 R2」として出力されます。
R*² = 1 −(1 − R²)×(n − 1)÷(n − k − 1)
n はデータ件数、k は説明変数の数。大きいほど良いモデル
実際に計算します。データ20件で、説明変数3個のときR²=0.80。ここに変数を1つ足したらR²=0.81に上がった、というケースです。
変数3個のとき。n − 1 = 19、n − k − 1 = 20 − 3 − 1 = 16。
1 − 0.80 = 0.20 なので、0.20 × 19 ÷ 16 = 0.2375。
R*² = 1 − 0.2375 = 0.7625。
変数4個のとき。n − k − 1 = 20 − 4 − 1 = 15。
1 − 0.81 = 0.19 なので、0.19 × 19 ÷ 15 = 0.2407。
R*² = 1 − 0.2407 = 0.7593。
R²は 0.80 → 0.81 に上がったのに、R*²は 0.7625 → 0.7593 に下がりました。「その変数は割に合っていない」という判定です。
つまり、R*²は変数を足したときに勝手に上がらないのです。ここがR²との決定的な違いであり、モデル比較にR*²を使う理由です。R²そのものの意味を確認したい方は決定係数R²とは?もあわせてどうぞ。
② Cp統計量|「パラメータ数と同じくらい」が合格
Cp統計量(マローズのCp)は、総当たり法の出力表に必ず並んでいる指標です。使い方が少し独特で、「小さいほど良い」ではなく「パラメータ数(説明変数の数+1)に近く、かつ小さい」ものを選びます。
| Cpの様子 | 意味 |
|---|---|
| Cp ≒ 説明変数の数+1 | ちょうどいいモデル。有力な候補 |
| Cp がそれより大きい | 大事な変数が抜けている疑い |
| Cp がそれより小さい | たまたま当てはまりすぎている可能性 |
たとえば説明変数3個のモデルなら、パラメータ数は 3 + 1 = 4。Cpが4前後なら合格ライン、Cpが12なども大きすぎる場合は「まだ入れるべき変数がある」というサインです。
Cpの計算には「全変数を入れたモデルの誤差の大きさ」が使われます。そのため同じデータ・同じ候補変数のセットの中でだけ比較できます。別の分析のCpと見比べても意味がないので注意してください。
③ AIC|「小さいほど良い」で迷わない
AIC(赤池情報量規準)は、日本人統計学者の赤池弘次氏が考案した指標で、いまや世界標準です。中身は次の2つの足し算です。
AIC = 当てはまりの悪さ + 2 × パラメータ数
小さいほど良いモデル。数値そのものの大きさに意味はなく、比較にのみ使う
前半は「予測が外れているほど大きくなる項」、後半は「変数を使いすぎた罰金」です。だからあてはまりが良くて、しかも変数が少ないモデルがAIC最小になります。
似た指標にBIC(ベイズ情報量規準)もあり、こちらは罰金が重く、より変数の少ないモデルを選びます。
3つの指標まとめ
| 指標 | 良いのは | こんなときに使う |
|---|---|---|
| R*²(自由度調整済み寄与率) | 大きいほど良い | Excelで手早く比べたいとき |
| Cp統計量 | パラメータ数に近い | 総当たり法の出力表を読むとき |
| AIC | 小さいほど良い | 迷ったときの標準。予測重視 |
| R²(寄与率) | — | モデル比較には使わない |
これらの指標を使って全組み合わせを比べる方法が「総当たり法」です。手順やステップワイズ法との違いは変数選択の方法とAICの使い方で詳しく解説しています。
実際の進め方|この順番で点検すれば抜けがない
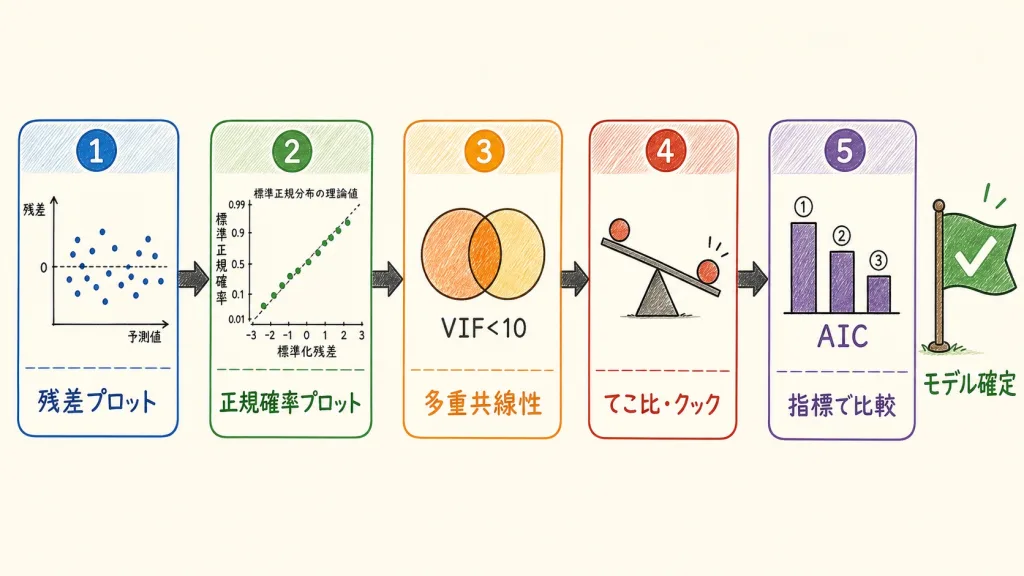
回帰診断は、順番を決めておくと迷いません。おすすめは「残差プロット → 正規確率プロット → VIF → てこ比・クックの距離 → 指標でモデル比較」の5ステップです。前の段階で問題が見つかったら、そこを直してから次に進みます。
残差プロットを描く。ランダムならOK。曲線が見えたら2乗項の追加や対数変換を検討。右に広がっていたらyの対数変換を検討します。
正規確率プロットを見る。ほぼ直線なら合格。大きく反っていたら、外れ値の混入や変換の必要性を疑います。
VIFを確認する(重回帰のみ)。10を超える変数があれば、片方を削るか合成します。係数の符号が理論と逆になっていないかも同時にチェック。
てこ比とクックの距離を見る。目立つ点があれば、まず入力ミスを確認。次に特別な事情を探します。抜いた場合と両方で計算して結論が変わるか確かめます。
R*²・Cp・AICでモデルを比べる。ここでも1位を機械的に採用せず、上位数モデルを並べて、係数の符号が理論と合うものを選びます。
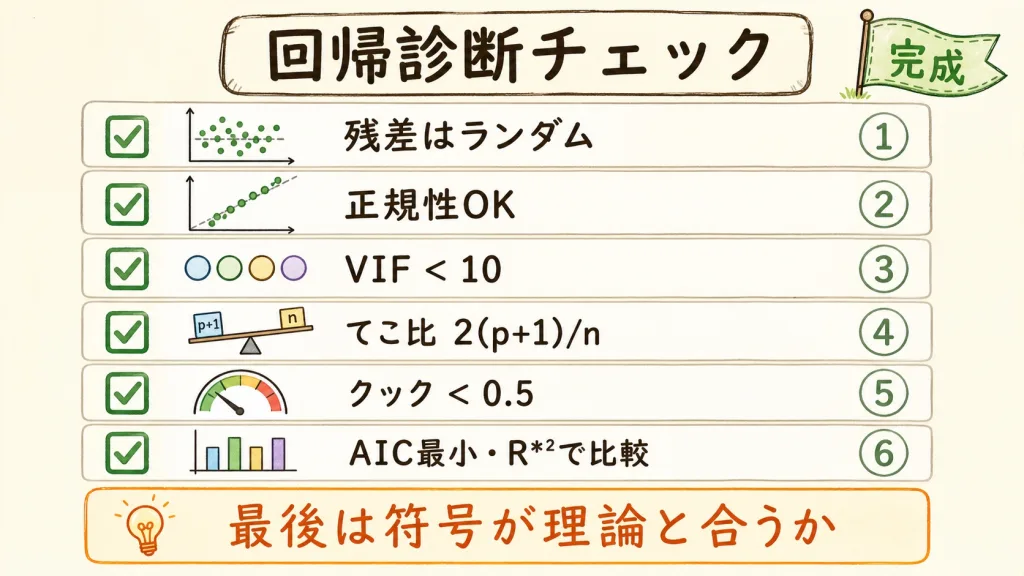
印刷して使える・回帰診断チェックリスト
| 見るもの | 合格の状態 | 目安の数値 |
|---|---|---|
| 残差プロット | ランダムに散らばる | (目で見て判断) |
| 正規確率プロット | 点が直線に乗る | (目で見て判断) |
| VIF | 小さい | 10未満(5未満が理想) |
| てこ比 | 目立つ点がない | 2(p+1)/n 未満 |
| クックの距離 | 全点が小さい | 0.5未満(1.0以上は要調査) |
| R*²・Cp・AIC | 他モデルより良い | Cp≒p+1/AICは最小 |
| 係数の符号 | 理論と一致している | (内容で判断) |
すべての数値が合格でも、「気温が上がるとアイスの売上が減る」のような理論と逆の符号が出ていたら、そのモデルは使えません。多重共線性か、重要な変数の抜けが原因です。数字より内容の納得感が優先——これが回帰診断のいちばん大事な心構えです。
つまずきやすいポイント4つ|先に知っておくと安心です
回帰診断で多くの人が同じところでつまずきます。先回りしてお伝えします。
①「R²が高いから良いモデル」と思ってしまう
これがいちばん多い誤解です。R²が0.99でも、残差に明確な曲線パターンが出ていれば、そのモデルは形が間違っています。
つまり、R²は「今あるデータへの当てはまり」しか教えてくれません。新しいデータで当たるかどうかは、別の話なのです。
②残差プロットの横軸に「x」を使ってしまう
残差プロットの横軸は、原則として予測値です。説明変数が複数あるとき、横軸をxのどれかにすると、その変数だけの見え方になってしまいます。
予測値を横軸にすれば、すべての変数の影響をまとめて確認できます。ただし、非線形性の原因になっている変数を特定したいときは、あえて個別のxを横軸にとるのも有効です。
③目的変数との相関だけを見てVIFを判断する
VIFで見るのは説明変数どうしの関係です。目的変数(売上など)は登場しません。
ここは本当に混乱しやすいところです。「売上との相関が強い変数を残せばいい」という発想とは、まったく別の話だと切り分けてください。
「相関行列を見て、0.8以上のペアがないから大丈夫」——これは不十分です。3つ以上の変数が組み合わさって初めて生じる多重共線性があり、2つずつの相関では見えません。たとえば「x₃ = x₁ + x₂」の関係があっても、x₁とx₃の相関は強くないことがあります。だからVIFを計算するのです。
④残差が大きい点=消すべき点だと思ってしまう
残差が大きくても、その点が回帰式を動かしていないなら、慌てて対処する必要はありません。逆に、残差はそれほど大きくないのに、回帰式を強く引っ張っている点もあります。
残差が大きい点
- 予測が外れただけ
- データの真ん中付近なら影響は小さい
- 「なぜ外れたか」を考える材料になる
影響の大きい点
- 回帰式そのものを動かしている
- 残差は小さいこともある
- クックの距離でしか見つけられない
つまり、「目立つ点」と「危ない点」は別です。だから残差プロットとクックの距離の両方を見る必要があるのです。
よくある質問(回帰診断について)
まとめ|回帰診断は5か所を見るだけです
回帰分析は「実行して数字が出たら終わり」ではありません。むしろ、そこからが本番です。とはいえ、見るところは5か所だけ。慣れれば数分で終わります。
- 残差プロット:ランダムならOK。曲線なら非線形性、右へ広がれば不等分散
- 正規確率プロット:点が直線に乗れば正規性は合格
- VIF = 1 ÷(1 − R²):10を超えたら多重共線性を疑う
- てこ比:目安は 2(p+1)÷n。xが極端な位置にある点を見つける
- クックの距離:0.5以上で影響大、1.0以上で要調査
- R*²・Cp・AIC:モデル比較の指標。R²は使わない(変数を増やせば必ず上がる)
- 最後は係数の符号が理論と合っているかで判断する
診断のやり方がわかったら、次は「どの変数を残すか」を決める段階です。総当たり法やステップワイズ法の使い分けを押さえると、回帰分析はぐっと実務で使える道具になります。
まずは手元のデータで残差プロットを1枚描いてみてください。Excelの分析ツールでもすぐ出せます。「ランダムに散らばっているか」を自分の目で確かめた経験が、回帰診断のいちばんの近道になります。
📚 次に読むべき記事
相関分析から重回帰まで、どの順番で学べばいいかを1ページで整理しています。
係数の符号が逆転する原因と、VIFの使い方・対処法をさらに詳しく解説します。
診断のあとに来る「どの変数を残すか」の判断を、手順つきで解説しています。