※本記事にはプロモーション(広告)が含まれています。
「回帰分析で分散分析表が出てきたけど、何を計算しているの?」
「SR、Se、STって何の略?どうやって求めるの?」
「F検定で"有意"って判定されたけど、何が言えるの?」
こんな疑問、抱えていませんか?
回帰直線を引いただけでは、「その直線が本当に意味があるのか」がわかりません。分散分析表を使えば、回帰式の有意性を客観的に判定できます。
結論ファースト
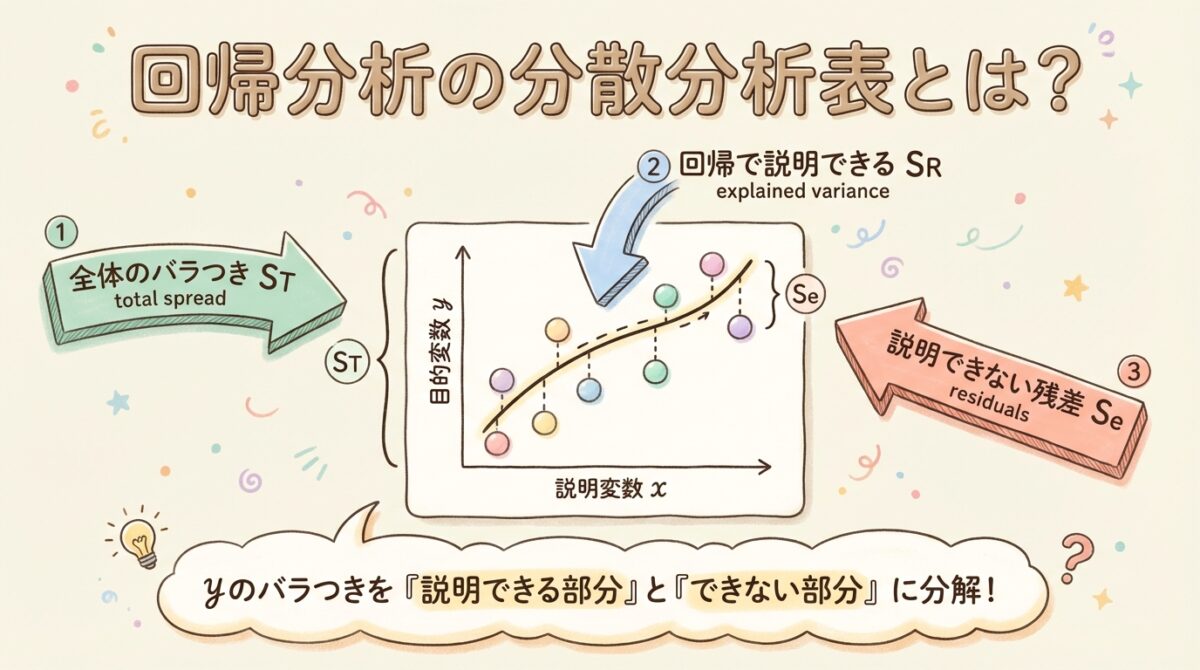
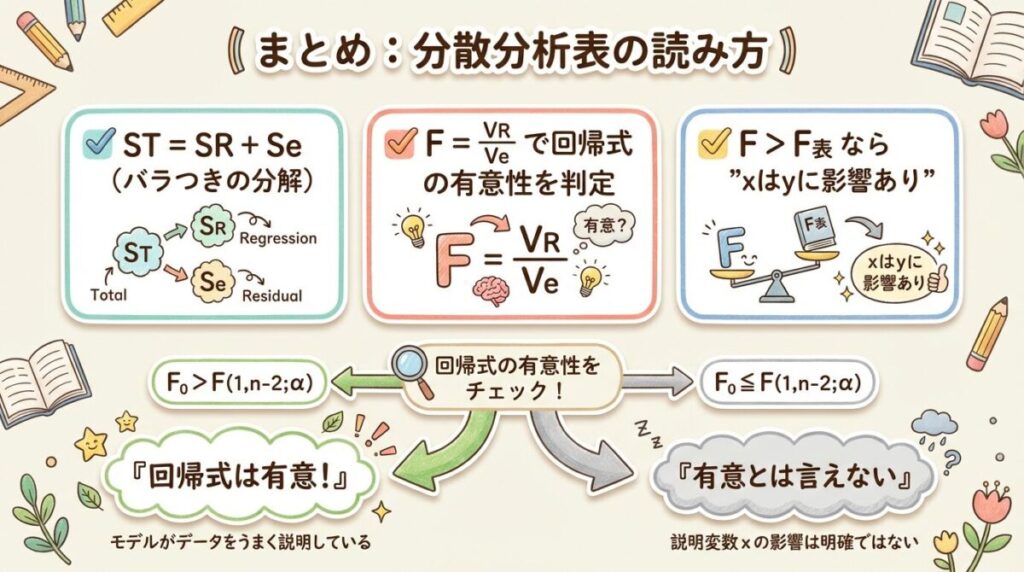
回帰分析の分散分析表は、yのバラつき(ST)を「回帰で説明できる部分(SR)」と「説明できない残差(Se)」に分解します。F検定で「SR/Se」の比が大きければ、回帰式は有意(xはyに影響する)と判定できます。
この記事でわかること
- 3つの平方和(ST, SR, Se)の意味と計算方法
- 分散分析表の構造と作り方
- F検定で回帰式の有意性を判定する方法
- 計算例で手を動かして完全理解
前提知識:単回帰分析の基礎を理解している方向けです。まだの方は以下もどうぞ。
→ 回帰分析とは?「未来を予測する」仕組み
→ 最小二乗法とは?回帰直線を引く仕組み
残差平方和(Se)とは、実測値 y と回帰式の予測値 ŷ の差(残差)を2乗して合計した値で、Se=Σ(y−ŷ)² です。回帰直線では説明できなかったばらつきの大きさを表し、全体平方和から回帰平方和を引いても求まります(Se=ST−SR)。分散分析表では Se を自由度 n−2 で割った Ve を使い、F₀=VR/Ve で回帰式が有意かを判定します。
3つの平方和を理解する
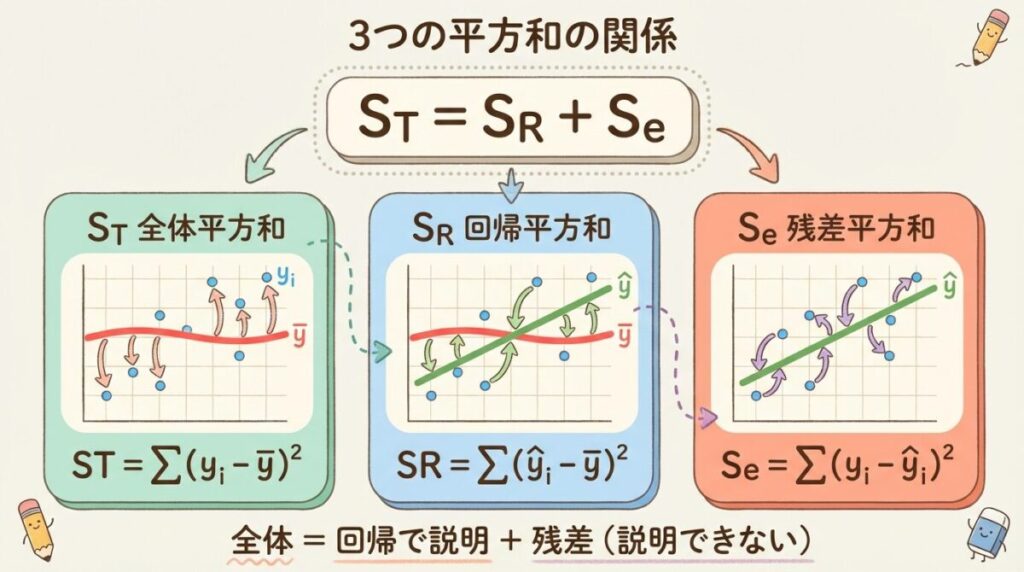
回帰分析の分散分析では、yのバラつき(変動)を3つに分解します。これが分散分析表の基本です。
バラつき分解の基本式
ST = SR + Se
全体のバラつき = 回帰で説明できる部分 + 説明できない残差
各平方和の定義
ST:全体平方和
Total Sum of Squares
ST = Σ(yi − ȳ)²
意味:各データが平均ȳからどれだけ離れているか(yの全バラつき)
SR:回帰平方和
Regression Sum of Squares
SR = Σ(ŷi − ȳ)²
意味:回帰直線上の予測値が平均からどれだけ離れているか(回帰で説明できる部分)
Se:残差平方和
Error Sum of Squares
Se = Σ(yi − ŷi)²
意味:実測値と予測値のズレ(回帰で説明できない残差)
イメージで理解:テストの点数
生徒の数学の点数(y)を、勉強時間(x)で予測する場面を想像してください。
ST:生徒ごとの点数のバラつき(全体の散らばり)
SR:「勉強時間」で説明できる点数の差
Se:勉強時間では説明できない個人差(才能、体調など)
SR が大きいほど「勉強時間が点数に影響している」と言えます。
決定係数R²との関係
実は、決定係数R²は平方和を使って表せます。
R² = SR/ST = 1 − Se/ST
R² = 「全体のバラつきのうち、回帰で説明できる割合」
自由度の分解
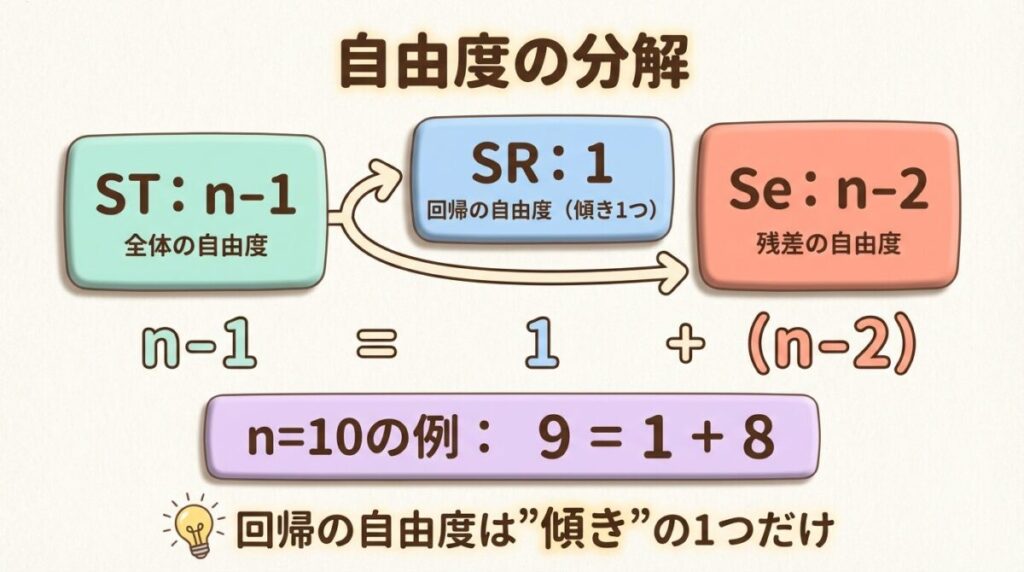
平方和だけでなく、自由度も分解されます。これが分散分析表の重要なポイントです。
自由度の内訳
φT = φR + φe
(n − 1) = 1 + (n − 2)
分散分析表の構造
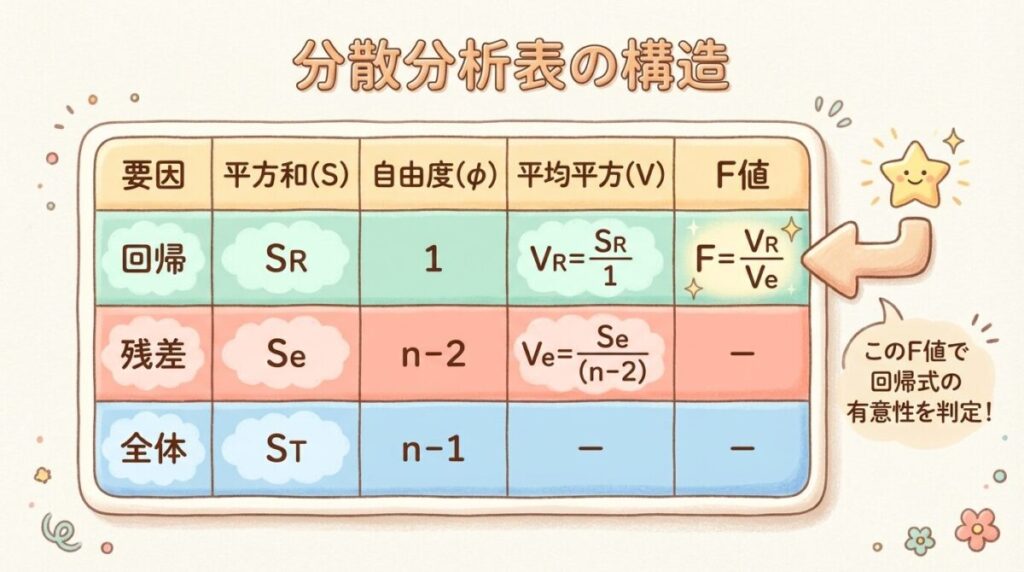
分散分析表は、以下の5列で構成されます。
分散分析表のテンプレート
| 要因 | 平方和 S | 自由度 φ | 平均平方 V | F値 |
|---|---|---|---|---|
| 回帰 R | SR | 1 | VR = SR/1 | F₀ = VR/Ve |
| 残差 e | Se | n − 2 | Ve = Se/(n−2) | − |
| 全体 T | ST | n − 1 | − | − |
各列の意味:
- 平方和 S:バラつきの大きさ(二乗和)
- 自由度 φ:自由に動ける値の数
- 平均平方 V:平方和 ÷ 自由度(分散の推定値)
- F値:VR/Ve(回帰の効果 ÷ 誤差の比)
F検定の判定方法
F検定の判定基準
帰無仮説 H₀:傾きβ = 0(xはyに影響しない)
対立仮説 H₁:傾きβ ≠ 0(xはyに影響する)
F₀ > F(1, n−2; α) ならば H₀を棄却(回帰式は有意)
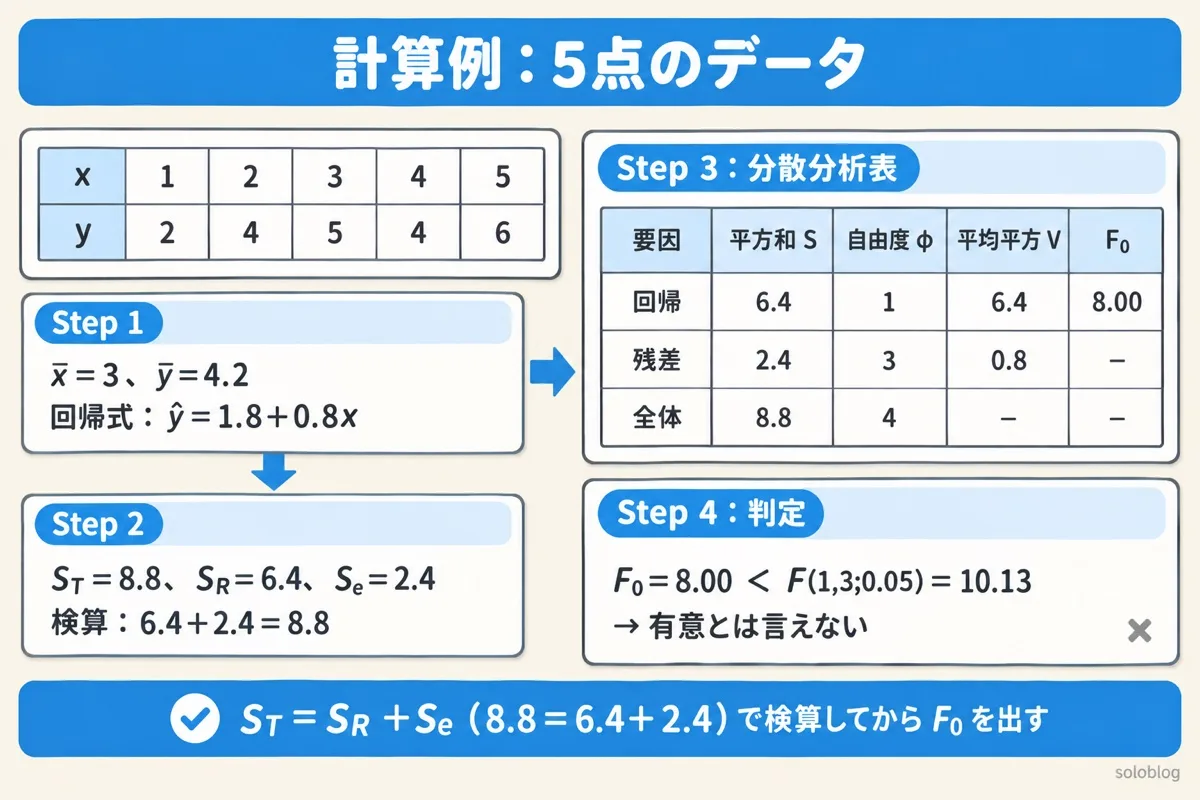
計算例:5点のデータで分散分析表を作成
以下のデータを使って、分散分析表を作成し、回帰式の有意性を検定してみましょう。
データ(n = 5)
| i | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| x | 1 | 2 | 3 | 4 | 5 |
| y | 2 | 4 | 5 | 4 | 6 |
Step 1:基本統計量の計算
平均:x̄ = (1+2+3+4+5)/5 = 3 , ȳ = (2+4+5+4+6)/5 = 4.2
偏差の積和:Σ(x−x̄)(y−ȳ) = (−2)(−2.2) + (−1)(−0.2) + (0)(0.8) + (1)(−0.2) + (2)(1.8) = 4.4 + 0.2 + 0 − 0.2 + 3.6 = 8
xの偏差平方和:Σ(x−x̄)² = 4 + 1 + 0 + 1 + 4 = 10
Step 2:回帰係数の計算
傾き b = Σ(x−x̄)(y−ȳ) / Σ(x−x̄)² = 8 / 10 = 0.8
切片 a = ȳ − b × x̄ = 4.2 − 0.8 × 3 = 1.8
回帰式:ŷ = 1.8 + 0.8x
Step 3:予測値ŷの計算
| i | x | y | ŷ = 1.8+0.8x | y − ȳ | ŷ − ȳ | y − ŷ |
|---|---|---|---|---|---|---|
| 1 | 1 | 2 | 2.6 | −2.2 | −1.6 | −0.6 |
| 2 | 2 | 4 | 3.4 | −0.2 | −0.8 | +0.6 |
| 3 | 3 | 5 | 4.2 | +0.8 | 0 | +0.8 |
| 4 | 4 | 4 | 5.0 | −0.2 | +0.8 | −1.0 |
| 5 | 5 | 6 | 5.8 | +1.8 | +1.6 | +0.2 |
Step 4:3つの平方和を計算
ST = Σ(y−ȳ)² = (−2.2)² + (−0.2)² + (0.8)² + (−0.2)² + (1.8)² = 4.84 + 0.04 + 0.64 + 0.04 + 3.24 = 8.8
SR = Σ(ŷ−ȳ)² = (−1.6)² + (−0.8)² + (0)² + (0.8)² + (1.6)² = 2.56 + 0.64 + 0 + 0.64 + 2.56 = 6.4
Se = Σ(y−ŷ)² = (−0.6)² + (0.6)² + (0.8)² + (−1.0)² + (0.2)² = 0.36 + 0.36 + 0.64 + 1.0 + 0.04 = 2.4
検算:ST = SR + Se → 8.8 = 6.4 + 2.4 (一致)
簡便公式を使う方法
SR = b × Σ(x−x̄)(y−ȳ) = 0.8 × 8 = 6.4
Se = ST − SR = 8.8 − 6.4 = 2.4(上の計算と一致)
Step 5:分散分析表の完成
| 要因 | 平方和 S | 自由度 φ | 平均平方 V | F₀ |
|---|---|---|---|---|
| 回帰 R | 6.4 | 1 | 6.4 | 8.00 |
| 残差 e | 2.4 | 3 | 0.8 | − |
| 全体 T | 8.8 | 4 | − | − |
F₀の計算:F₀ = VR / Ve = 6.4 / 0.8 = 8.00
残差平方和を Excel で求める|3つの関数
上の5点のデータ(x を A2:A6、y を B2:B6 に入力)を使って、Excel で3つの平方和を確かめます。手計算の答え(ST=8.8、SR=6.4、Se=2.4)と同じ値になります。
| 求めるもの | Excel の式 | 結果 |
|---|---|---|
| 全体平方和 ST | =DEVSQ(B2:B6) | 8.8 |
| 回帰平方和 SR | =INDEX(LINEST(B2:B6,A2:A6,TRUE,TRUE),5,1) | 6.4 |
| 残差平方和 Se | =INDEX(LINEST(B2:B6,A2:A6,TRUE,TRUE),5,2) | 2.4 |
DEVSQ は「平均からの偏差の2乗の合計」を返す関数です。LINEST の4つ目の引数を TRUE にすると、回帰の統計量の表が返り、その5行目に回帰平方和(1列目)と残差平方和(2列目)が入っています。
予測値の列を作って確かめる方法
手順1 C2:C6 に予測値を出す:C2:C6 を選んで =TREND(B2:B6,A2:A6)(2.6・3.4・4.2・5.0・5.8 になる)
手順2 残差平方和:=SUMXMY2(B2:B6,C2:C6)(2つの範囲の差の2乗の合計)→ 2.4
残差平方和から「予測のずれの大きさ」を出す
残差平方和は2乗の合計なので、そのままでは単位が y の2乗になり、大きさがつかみにくい値です。自由度で割って平方根をとると、y と同じ単位の「予測のずれの標準的な大きさ」になります。この例では Ve=2.4÷3=0.8、√0.8≒0.89。予測値に対して、実測値はおおよそ ±0.9 程度ばらつく、と読めます(Excel では =STEYX(B2:B6,A2:A6) で同じ値が出ます)。
残差平方和 Se=Σ(y−ŷ)²=ST−SR。Excel では LINEST の5行目2列目、または TREND と SUMXMY2 で求める。√(Se÷(n−2)) で予測のずれの大きさになる。
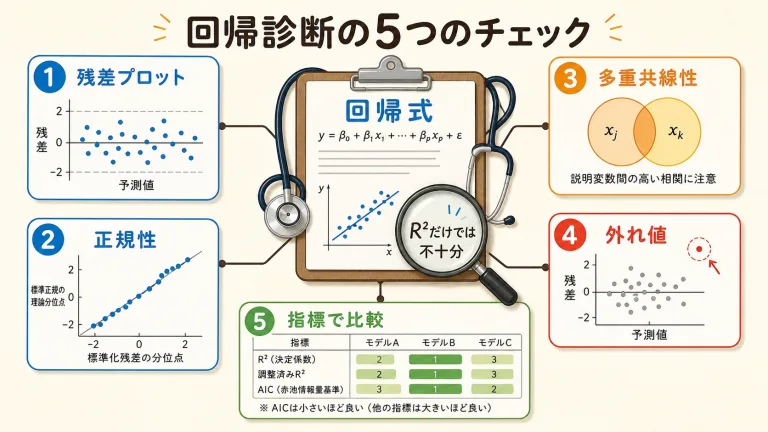
残差平方和を出したら、残差のくせを残差プロットで確かめる回帰診断に進みます。
よくある質問
F検定による判定
F分布表との比較
有意水準α = 0.05で検定します。
F分布表より:F(1, 3; 0.05) = 10.13
計算したF値:F₀ = 8.00
判定結果
F₀ = 8.00 < F(1, 3; 0.05) = 10.13
→ 帰無仮説を棄却できない(有意水準5%で有意とは言えない)
結果の解釈
この例では、「xがyに影響する」とは言えないという結果になりました。
ただし、これは「影響がない」ことを証明したわけではありません。サンプルサイズがn=5と小さいため、効果を検出するパワーが不足している可能性があります。
参考:R² = SR/ST = 6.4/8.8 ≒ 0.73(回帰で約73%を説明)
一歩進んで:当てはまりの悪さ(Lack of Fit)の検定|「直線でよいか」を確かめる
上のF検定で確かめたのは、「傾きがあるか(xはyに影響するか)」でした。でも、本当は曲線の関係なのに直線を引いていても、傾きは有意になりますし、R²もそこそこ高くなります。
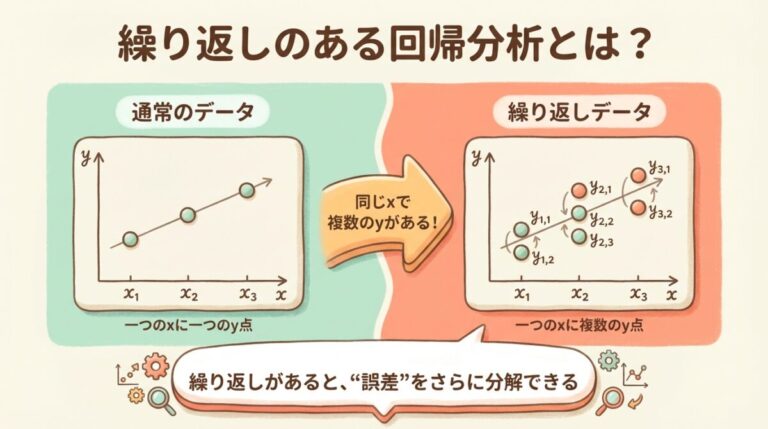
そこで、同じxでyを何回か測ったデータ(繰り返しのあるデータ)があるときは、残差 Se をさらに2つに分けて、「直線という形そのものでよいか」を検定できます。これが Lack of Fit(当てはまりの悪さ)の検定です。
残差には2つの原因がある|「射撃の的」で考える
射撃で的の中心から弾がずれる原因は、2つあります。
| 射撃では | 回帰分析では | 記号 |
|---|---|---|
| 腕のブレ(狙いは正しいのに手が震える) | 純粋誤差:同じxで測っても出る、避けられないバラつき | SPE |
| 照準のズレ(照準器そのものがずれている) | 当てはまりの悪さ:直線という形では説明しきれないズレ | SLOF |
Se = SLOF + SPE
繰り返しのデータが必要な理由
x=2 のときの y が1つしかなければ、そのズレが「腕のブレ」なのか「照準のズレ」なのか区別できません。同じ x=2 で y を3回測れば、その3つのバラつきが純粋誤差の大きさを教えてくれます。繰り返しのないデータでは、この検定はできません。
分散分析表を広げる|残差の行を2つに分ける
n はデータの総数、k は x の水準の数(何種類の x で測ったか)です。
| 要因 | 平方和 S | 自由度 φ | 平均平方 V | F₀ |
|---|---|---|---|---|
| 回帰 R | SR | 1 | VR | − |
| 当てはまりの悪さ LOF | SLOF | k − 2 | VLOF | VLOF / VPE |
| 純粋誤差 PE | SPE | n − k | VPE | − |
| 残差 e(合計) | Se | n − 2 | − | − |
| 全体 T | ST | n − 1 | − | − |
自由度の検算:1 + (k − 2) + (n − k) = n − 1(全体と一致)。LOF の k − 2 は「水準の数 − 回帰で決めた a と b の2つ」、PE の n − k は「各水準の (繰り返し数 − 1) の合計」です。
2つの平方和の求め方
純粋誤差:SPE = ΣΣ(yij − ȳi)² … 水準ごとに「その水準の平均からのズレ」を2乗して全部足す(一元配置の群内平方和と同じ計算)
当てはまりの悪さ:SLOF = Se − SPE = Σ ni(ȳi − ŷi)² … 水準ごとの「実測の平均」と「直線の予測値」のズレ
直線が正しければ、各水準の平均は直線の上にほぼ乗るので SLOF は小さくなります。曲がった関係を直線で近似していると、ここが大きくなります。
Lack of Fit の検定の判定基準
帰無仮説 H₀:直線モデルでよい(当てはまりの悪さはない)
対立仮説 H₁:直線モデルでは足りない
F₀ = VLOF / VPE ≧ F(k−2, n−k; α) ならば H₀を棄却(直線では足りない)
計算例:4つの温度で3回ずつ測った強度
加熱温度の水準 x(1〜4)ごとに、製品の強度 y を3回ずつ測りました(n = 12、k = 4)。
| x | y(3回) | 水準の平均 ȳi | 直線の予測 ŷi | ズレ ȳi − ŷi |
|---|---|---|---|---|
| 1 | 3, 4, 5 | 4.0 | 3.2 | +0.8 |
| 2 | 5, 6, 7 | 6.0 | 6.9 | −0.9 |
| 3 | 9, 10, 11 | 10.0 | 10.6 | −0.6 |
| 4 | 14, 15, 16 | 15.0 | 14.3 | +0.7 |
Step 1:回帰直線
x̄ = 2.5、ȳ = 8.75、Sxx = 3 × (2.25 + 0.25 + 0.25 + 2.25) = 15、Sxy = 55.5
b = 55.5 / 15 = 3.7、a = 8.75 − 3.7 × 2.5 = −0.5 → ŷ = −0.5 + 3.7x
Step 2:全体・回帰・残差の平方和
ST = Σ(y − 8.75)² = 33.0625 + 22.5625 + 14.0625 + 14.0625 + 7.5625 + 3.0625 + 0.0625 + 1.5625 + 5.0625 + 27.5625 + 39.0625 + 52.5625 = 220.25
SR = b × Sxy = 3.7 × 55.5 = 205.35
Se = ST − SR = 220.25 − 205.35 = 14.90
Step 3:純粋誤差と当てはまりの悪さ
各水準の中のズレは (−1)² + 0² + 1² = 2 が4水準なので、SPE = 2 × 4 = 8.00
SLOF = Se − SPE = 14.90 − 8.00 = 6.90
検算:Σ ni(ȳi − ŷi)² = 3 × (0.64 + 0.81 + 0.36 + 0.49) = 3 × 2.30 = 6.90(一致)
Step 4:分散分析表
| 要因 | 平方和 S | 自由度 φ | 平均平方 V | F₀ |
|---|---|---|---|---|
| 回帰 R | 205.35 | 1 | 205.35 | − |
| 当てはまりの悪さ LOF | 6.90 | 2 | 3.45 | 3.45 |
| 純粋誤差 PE | 8.00 | 8 | 1.00 | − |
| 残差 e(合計) | 14.90 | 10 | − | − |
| 全体 T | 220.25 | 11 | − | − |
判定結果
F₀ = 3.45 / 1.00 = 3.45 < F(2, 8; 0.05) = 4.46
→ 帰無仮説を棄却できない(直線モデルで足りないとは言えない)
照準のズレ(VLOF = 3.45)は、腕のブレ(VPE = 1.00)の約3.5倍ありますが、F分布で見ると偶然の範囲です。この例では ŷ = −0.5 + 3.7x を使ってよいと判断します。ただし「直線が完璧」と証明したのではなく、「このデータでは直線の不足を見つけられなかった」という意味です。
有意になったら? よくある疑問
Lack of Fit が有意だったとき:直線では形が合っていません。次のどれかを試します。
- 2次の項を足す(ŷ = a + bx + cx²)。いちばんよく使う方法
- x や y を対数・平方根などに変換して、直線になる目盛りで回帰する
- x の範囲を分けて、それぞれに直線を当てる
繰り返しの回数がそろっていなくてもよい?:できます。純粋誤差の自由度は Σ(ni − 1) = n − k のままです。繰り返しが1回の水準は純粋誤差に入らないので、できれば各水準2回以上にします。
R² が高いのに有意になることは?:あります。R² は「どれだけ説明できたか」、Lack of Fit は「形が正しいか」を見ています。R² が0.95でも、残差に弓なりの形が残っていれば有意になりえます。
まとめ
- 分散分析表はyのバラつきを分解する:ST = SR + Se
- ST:全体のバラつき、SR:回帰で説明、Se:残差
- 自由度:全体(n−1) = 回帰(1) + 残差(n−2)
- F₀ = VR/Ve で回帰式の有意性を検定
- F₀ > F(1, n−2; α) なら「xはyに影響する」と言える
公式まとめ
ST = Σ(yi − ȳ)²
SR = Σ(ŷi − ȳ)² = b × Σ(xi − x̄)(yi − ȳ)
Se = ST − SR
F₀ = (SR/1) / (Se/(n−2))
試験対策のポイント
QC検定や統計検定では、分散分析表の空欄を埋める問題が頻出です。「SR = b × Sxy」の簡便公式を使えば計算が速くなります。また、自由度の分解(n−1 = 1 + n−2)を覚えておくと確実に得点できます。
NEXT STEP
次は「残差プロットの見方」を学びましょう。回帰分析の前提条件(等分散性・正規性・独立性)を目視でチェックする方法がわかります。
残差プロットの見方 →
最後までお読みいただきありがとうございました!
ご質問・ご感想は @shirasusolo までお気軽にどうぞ。
回帰分析の考え方を、楽しく復習したいときに向いています。回帰分析の考え方を、マンガで解説した本です(オーム社)。

「単回帰の分散分析表」の土台になる統計学を、本でじっくり学び直したいときに向いています。統計学を独学で学べるように書かれた入門書です(ダイヤモンド社、小島寛之 著)。

メーカーで電気設計と品質保証に携わってきた経験をもとに執筆しています。むずかしい専門用語をできるだけ使わず、はじめて学ぶ人がつまずかないように、図とたとえで説明することを大切にしています。
次に読むべき記事
この記事の内容がわかったら、単回帰分析の次のテーマに進みましょう。続けて読むと、現場でそのまま使える知識になります。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめて学ぶ人向けにやさしく書いています。