※本記事にはプロモーション(広告)が含まれています。
こんにちは、シラスです。
前回まで、A工場とB工場のような「別々のグループ」を比較するt検定を紹介してきました。
しかし、実務や研究の世界では、もっと「強力な比較」ができるシチュエーションがあります。
それは、データが「ペア(対応)」になっている場合です。
- 「ダイエット前」と「ダイエット後」の体重
- 「投薬前」と「投薬後」の血圧
- 「右足」の靴底と「左足」の靴底の減り方
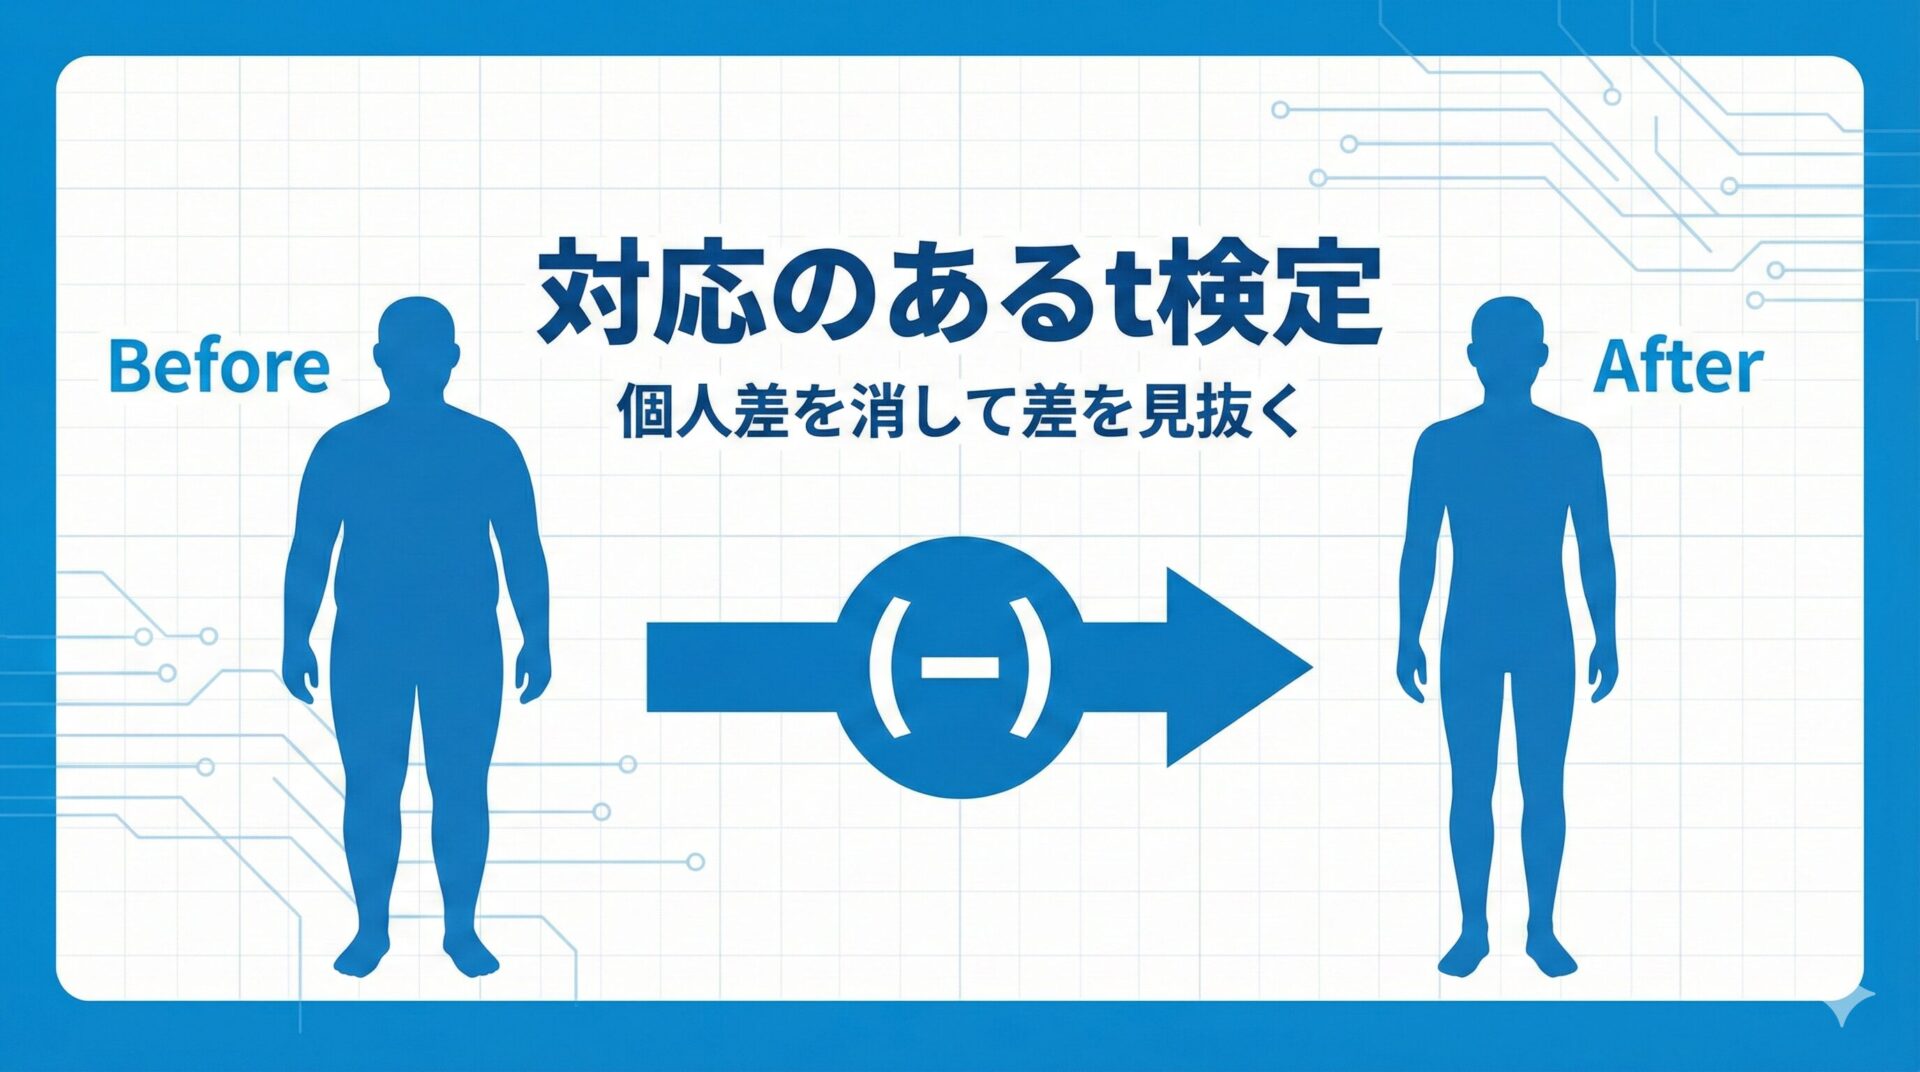
このように、同一の対象からデータを取れるとき、私たちは「対応のあるt検定」という最強の武器を使うことができます。
なぜ「最強」なのか?
それは、データの天敵である「個人差(バラつき)」を消し去ることができるからです。
1. そもそも「対応がある」とは?
まずはイメージを掴みましょう。
新しいダイエットサプリの効果を検証するとします。
ダメな比較(対応なし)
- Aさん、Bさん、Cさんには「サプリ」を飲ませる。
- Dさん、Eさん、Fさんには「偽薬」を飲ませる。
これだと、「Aさんが元々100kg」で「Dさんが元々50kg」だった場合、元々の体重差(個人差)が大きすぎて、サプリの効果(-2kg程度)が埋もれてしまいます。
良い比較(対応あり)
- Aさんの「飲む前」と「飲んだ後」を比べる。
- Bさんの「飲む前」と「飲んだ後」を比べる。
これなら、元々太っていようが痩せていようが関係ありません。
「その人がどう変化したか」だけを見ることができるからです。
2. 魔法のロジック:「差分」をとる
対応のあるt検定の計算は、驚くほどシンプルです。
- ペアごとに引き算をして、「差($d$)」を求める。
- その「差($d$)」の平均値が、0(ゼロ)と違うかを検定する。
つまり、2つのデータを比較しているようで、実は「差分データを使った、一標本のt検定」を行っているのと同じなのです。
計算式
- $\bar{d}$:差の平均値
- $s_d$:差の標準偏差
- $n$:ペアの数
以前紹介した「一標本のt検定」の公式($x$ が $d$ になっただけ)と全く同じ形ですね。
3. なぜ「最強」なのか?(ノイズキャンセリング)
この手法が優れている理由は、分母(標準誤差)が劇的に小さくなるからです。
普通のt検定では、分母に「個人差(体重のバラつき)」が含まれます。
しかし、対応のあるt検定では、引き算をした時点で「個人差」が消滅しています。
分母(ノイズ)が小さい
t値(シグナル)が巨大になる
微小な差でも「有意差あり」を見つけられる!
4. 実践:ダイエットの成果を検定する
具体的なデータで計算してみましょう。
| 被験者 | Before | After | 差 ($d$) |
|---|---|---|---|
| Aさん | 80kg | 78kg | -2 |
| Bさん | 60kg | 59kg | -1 |
| Cさん | 90kg | 87kg | -3 |
Before/Afterの体重自体はバラバラ(60kg〜90kg)ですが、差($d$)を見ると「全員減っている」ことが分かりますね。
ステップ1:差の平均と分散を出す
- 差データ: $\{-2, -1, -3\}$
- 平均 $\bar{d}$: $-2.0$
- 標準偏差 $s_d$: $1.0$
- データ数 $n$: $3$
ステップ2:t値を計算する
ステップ3:判定
自由度はペアの数から1引くので、$3 - 1 = 2$ です。
自由度2、有意水準5%の基準値は 4.303 です。
おっと!今回は $|-3.46| < 4.303$ なので、有意差なしとなってしまいました。
(※さすがにデータ数3人では少なすぎましたね。あと2人くらい同じ傾向なら有意になります)
まとめ
実験を計画するときは、可能な限り「ペアでデータが取れないか?」を考えてみてください。
もしペアで取れるなら、必要なサンプル数を劇的に減らすことができます。
さて、ここまで様々な検定で「差がある!」ことを証明してきました。
しかし、上司が本当に知りたいのは「差があるか?」ではなく、「で、結局どれくらい効果(メリット)があるの?」という具体的な数値です。
次回、検定シリーズ完結編。
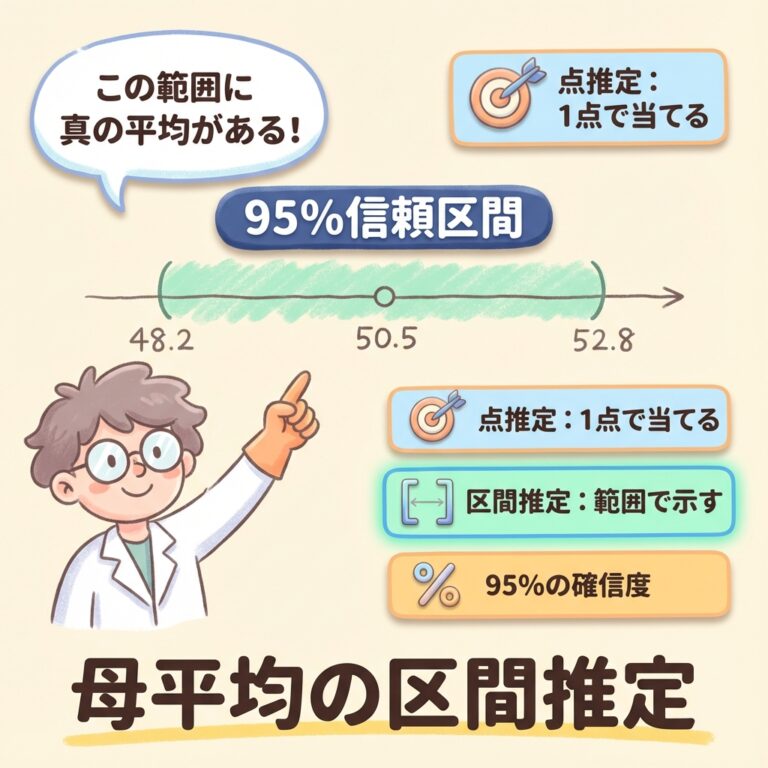
「真の平均値はどこにある?」を予測する、母平均の区間推定について解説します。
「対応のあるt検定ダイエットで痩せた」の土台になる統計学を、本でじっくり学び直したいときに向いています。統計学を独学で学べるように書かれた入門書です(ダイヤモンド社、小島寛之 著)。


QC検定2級の受験を考えているなら、過去問で出題のされ方を確かめておきましょう。QC検定2級の過去問題を、解説つきで学べる問題集です(日本規格協会、2026年版)。

「対応のあるt検定ダイエットで痩せた」の土台になる統計学を、検定まで含めて1冊で学びたいときに向いています。検定から多変量解析・実験計画法・ベイズ統計学までを扱う、統計学の入門書です(オーム社、栗原伸一 著、第2版)。

次に読むべき記事
この記事の内容がわかったら、検定と推定の次のテーマに進みましょう。続けて読むと、現場でそのまま使える知識になります。
テーマ別に、もっと深く学ぶ
気になるところから読んでも大丈夫です。どの記事も、はじめて学ぶ人向けにやさしく書いています。


メーカーで電気設計と品質保証に携わってきた経験をもとに執筆しています。むずかしい専門用語をできるだけ使わず、はじめて学ぶ人がつまずかないように、図とたとえで説明することを大切にしています。